Mau jadi AI Engineer tanpa pusing deep math? Mulai dari backend, API, SQL, Python, lalu Gemini/Claude API, RAG, evaluasi, dan deploy. Ini peta belajarnya.
Banyak orang menunda belajar AI engineering karena membayangkan harus menguasai kalkulus, aljabar linear, dan statistik tingkat lanjut lebih dulu. Padahal, untuk sebagian besar pekerjaan AI engineering di industri, yang dibangun adalah fitur berbasis model yang sudah jadi: chatbot yang menjawab dari dokumen perusahaan, ringkasan otomatis, klasifikasi tiket pelanggan, atau pencarian yang memahami makna.
Artikel ini membedah roadmap AI engineering yang dimulai dari fondasi yang lebih dekat: backend, API, database, dan Python. Tujuannya agar kamu, baik pemula maupun profesional yang ingin pindah jalur, tahu urutan belajar yang masuk akal, apa yang perlu dibuat di setiap tahap, dan kapan matematika benar-benar dibutuhkan.
Apa Itu AI Engineering dan Apa Bedanya dengan Peneliti atau Data Scientist?
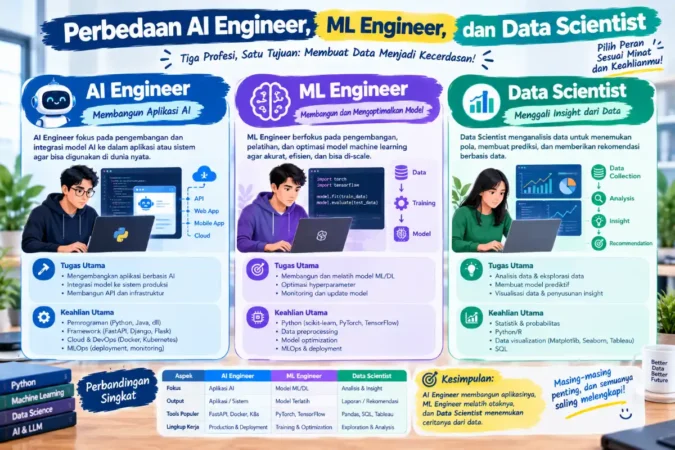
AI engineering adalah praktik membangun aplikasi dan sistem nyata yang memanfaatkan model AI, terutama model bahasa besar (LLM), sehingga fiturnya andal, aman, terukur, dan bisa dipakai pengguna. Seorang AI engineer biasanya tidak melatih model dari nol. Ia memilih model, merancang cara memanggilnya, menyambungkannya dengan data perusahaan, menguji kualitas keluarannya, lalu memasangkannya ke aplikasi produksi.
Bedanya dengan peneliti machine learning: peneliti berfokus pada arsitektur dan pelatihan model, sehingga matematika mendalam jadi kebutuhan harian. Bedanya dengan data scientist: data scientist lebih banyak menganalisis data untuk menghasilkan wawasan atau model prediktif. AI engineer berada di persimpangan rekayasa perangkat lunak dan AI terapan, sehingga latar belakang backend justru menjadi modal yang kuat.
Catatan kritis: istilah “AI engineer” belum punya definisi baku. Satu perusahaan bisa memakainya untuk posisi yang menuntut riset, perusahaan lain untuk posisi integrasi API. Selalu baca deskripsi lowongan, jangan hanya melihat judulnya. Data pasar kerja yang membahas skill AI paling dicari juga sudah kami rangkum di artikel skill programmer yang dibutuhkan di era AI.
Kenapa Tidak Harus Mulai dari Deep Math?
Ada tiga alasan praktis mengapa fondasi backend lebih masuk akal sebagai titik awal.
Model sudah tersedia lewat API. Untuk kebanyakan kasus, kamu memanggil model lewat layanan seperti Gemini API atau Claude API, bukan melatihnya sendiri.
Kegagalan terbesar ada di sistem, bukan di model. Masalah yang sering muncul di produksi adalah data tidak rapi, latensi tinggi, biaya membengkak, atau keluaran yang tidak bisa diparsing. Semuanya masalah rekayasa.
Pondasi backend membuat belajar AI lebih bermakna. Ketika kamu paham request, database, dan pengujian, konsep seperti embedding atau RAG terasa sebagai alat baru dalam kotak perkakas yang sudah kamu kenal.
Ini bukan berarti matematika tidak penting. Ia akan berguna ketika kamu ingin melatih atau menyesuaikan model, memahami metrik secara mendalam, atau berpindah ke peran riset. Tetapi urutannya bisa dibalik: bangun dulu kemampuan membuat fitur yang bekerja, baru perdalam teori sesuai kebutuhan.
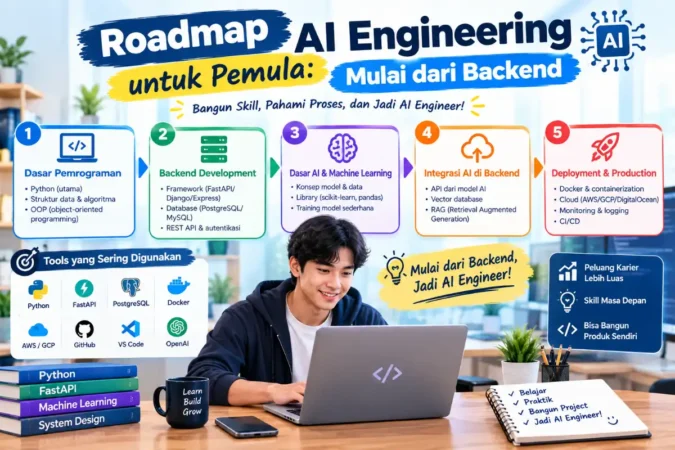
Roadmap AI Engineering dalam 9 Tahap
Jalur berikut disusun dari yang paling mendasar ke yang paling dekat dengan produksi. Kamu tidak harus menuntaskan satu tahap 100 persen sebelum lanjut, tetapi jangan melompati fondasinya.
Tahap 1
Backend Development
Pelajari cara kerja server: routing, autentikasi, validasi input, penanganan error, dan logging. Bahasa apa pun boleh dipakai, tetapi Python (dengan framework seperti FastAPI atau Flask) atau Node.js adalah pilihan yang umum untuk fitur AI. Target minimal: membuat REST API sederhana yang punya autentikasi dan bisa diuji.
Konsep yang sering diremehkan namun krusial untuk fitur AI adalah keandalan. Pemanggilan model bisa gagal atau tertunda, sehingga kamu perlu memahami retry dan penanganan permintaan ganda. Pembahasan yang relevan ada di artikel idempotency pada payment API, prinsipnya sama untuk endpoint AI yang berbiaya.
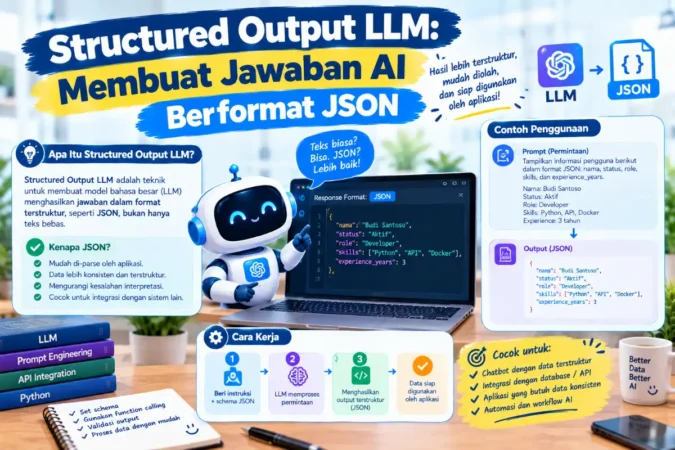
Hampir semua interaksi dengan model AI terjadi lewat HTTP dan JSON. Pahami metode request, header, kode status, paginasi, serta cara membaca dan memvalidasi JSON. Kemampuan memaksa model mengeluarkan JSON terstruktur (structured output) akan sangat sering kamu pakai.
Contoh di atas adalah bentuk keluaran yang ingin kamu dapatkan dari model saat mengklasifikasi tiket. Aplikasi kemudian memvalidasi bentuknya sebelum disimpan. Rujukan format ada di json.org.
Tahap 3
SQL dan Database
Data perusahaan hampir selalu tersimpan di database relasional. Kuasai SELECT, JOIN, GROUP BY, indeks, dan transaksi. Di tahap RAG nanti, kamu akan menyimpan metadata dokumen, riwayat percakapan, dan log evaluasi di database, dan beberapa sistem menyimpan vektor langsung di database yang sama.
SELECT kategori, COUNT(*) AS jumlah
FROM tiket
WHERE dibuat_pada >= '2026-09-01'
GROUP BY kategori
ORDER BY jumlah DESC;
Dokumentasi resmi PostgreSQL adalah sumber belajar yang rapi untuk tahap ini. Jika kamu penasaran mengapa transaksi dan penguncian penting saat banyak proses berjalan bersamaan, baca race condition dan database locking.
Tahap 4
Data Analysis Dasar
Kamu perlu bisa membersihkan data, menghitung ringkasan, dan membaca pola sederhana. Di dunia AI engineering, kemampuan ini dipakai untuk menyiapkan dokumen sumber, menganalisis kegagalan model, dan menghitung metrik kualitas. Cukup mulai dengan pandas, statistik deskriptif (rata-rata, median, distribusi), dan visualisasi dasar.
Tahap 5
Python
Python adalah bahasa dominan di ekosistem AI, sehingga contoh, SDK, dan pustaka pendukung paling lengkap tersedia di sini. Fokus pada fungsi, struktur data, penanganan file, pengelolaan lingkungan virtual, async, dan pengujian otomatis. Panduan resminya tersedia di tutorial Python.
Tahap 6
Integrasi Gemini dan Claude API
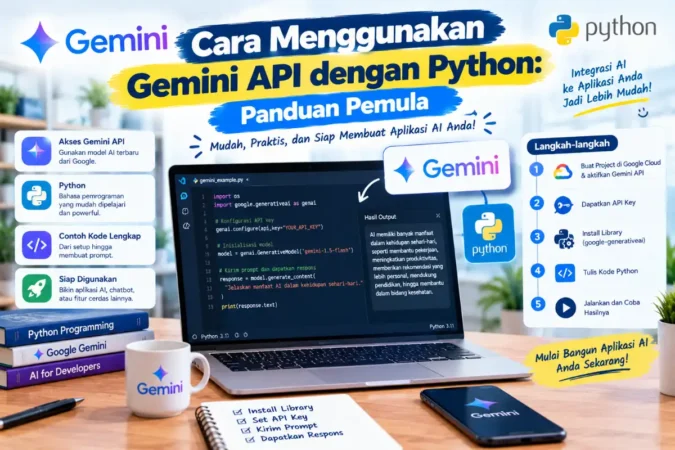
Di tahap inilah kamu mulai memanggil model. Pelajari cara mengirim pesan, mengatur instruksi sistem, mengontrol panjang keluaran, menangani streaming, memakai structured output, dan tool use atau function calling agar model bisa memanggil fungsi di aplikasimu. Coba lebih dari satu penyedia supaya kamu memahami perbedaan perilaku dan harga, karena keduanya punya kelebihan masing-masing.
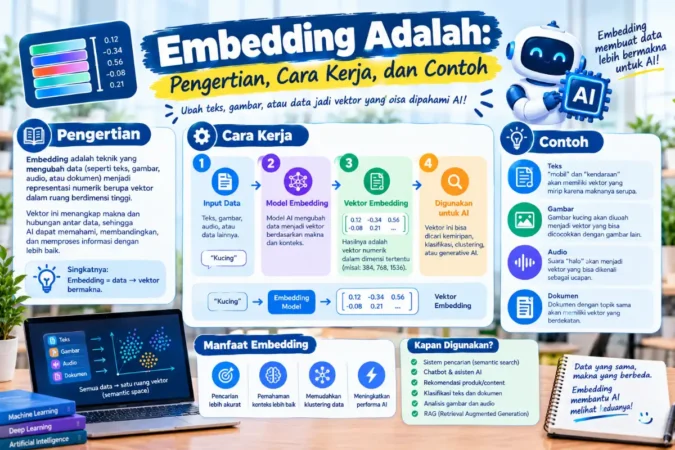
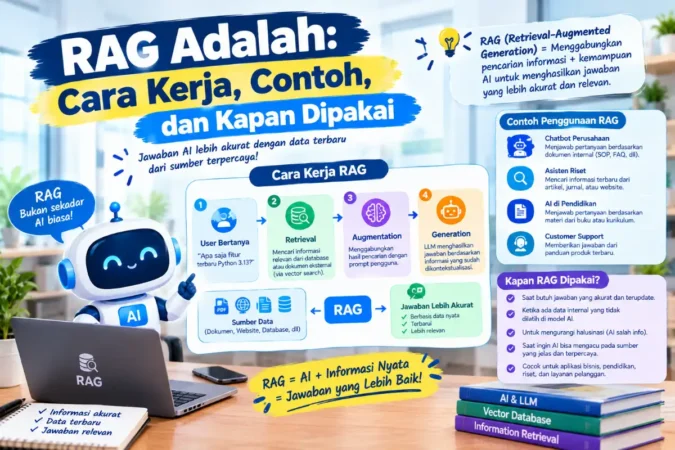
Embedding mengubah teks menjadi deretan angka (vektor) yang menangkap makna, sehingga teks yang mirip maknanya berada berdekatan. Retrieval-Augmented Generation (RAG) memakai ide ini: sistem mencari potongan dokumen paling relevan dari basis pengetahuanmu, lalu memberikannya kepada model sebagai konteks sebelum menjawab.
Alurnya kira-kira begini: dokumen dipecah menjadi potongan (chunking), setiap potongan diubah menjadi embedding, disimpan di penyimpanan vektor, lalu saat ada pertanyaan sistem mengambil potongan terdekat dan menyusun prompt. Kualitas RAG lebih ditentukan oleh kerapian data, strategi chunking, dan kualitas pencarian daripada oleh kecanggihan model. Kamu tidak perlu menurunkan rumus matematikanya; cukup pahami konsep kemiripan vektor dan cara mengujinya.
Jika ingin melihat contoh integrasi model dengan sumber data eksternal secara terstandar, baca apa itu Model Context Protocol.
Tahap 8
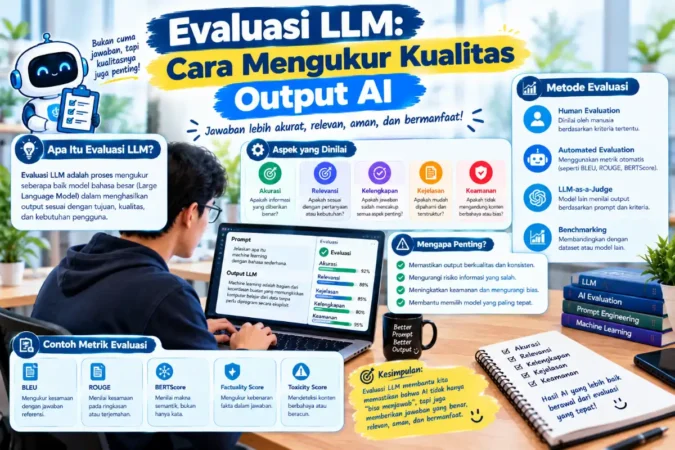
Evaluasi Output AI
Ini tahap yang paling membedakan AI engineer dari sekadar pengguna API. Model bisa terdengar meyakinkan padahal keliru (halusinasi), sehingga kamu butuh cara terukur untuk menilai kualitas. Mulailah dengan kumpulan uji kecil: 30 sampai 50 pertanyaan nyata beserta jawaban acuan. Jalankan setiap kali kamu mengubah prompt, model, atau strategi pencarian, lalu bandingkan hasilnya.
Beberapa hal yang layak diukur: ketepatan jawaban, apakah jawaban benar-benar bersumber dari dokumen, format keluaran yang valid, latensi, dan biaya per permintaan. Penilaian oleh model lain (LLM-as-judge) bisa membantu, tetapi hasilnya tetap perlu diperiksa sampel manual karena penilai otomatis juga bisa bias.
Tahap 9
Deploy Fitur AI ke Aplikasi
Fitur yang hanya jalan di laptop belum selesai. Saat deploy, pikirkan pembatasan laju (rate limit), penyimpanan kunci API yang aman, pencatatan permintaan dan biaya, batas waktu (timeout), serta cadangan ketika layanan model gangguan. Keamanan juga perlu diperhatikan, misalnya serangan prompt injection dan kebocoran data sensitif. Daftar risiko umum dirangkum di OWASP Top 10 untuk aplikasi LLM.
Ringkasan: Apa yang Dipelajari dan Apa yang Dihasilkan
Tahap
Fokus utama
Proyek mini yang bisa dibuat
1. Backend
Routing, autentikasi, logging
REST API catatan dengan login
2. API dan JSON
Request, validasi JSON
Pengambil data cuaca atau kurs yang divalidasi
3. SQL dan database
Query, indeks, transaksi
Database tiket pelanggan
4. Data analysis
Pembersihan dan ringkasan data
Laporan pola keluhan bulanan
5. Python
Skrip, async, pengujian
Skrip pemroses dokumen massal
6. Gemini/Claude API
Prompt, structured output, tool use
Pengklasifikasi tiket otomatis
7. Embedding dan RAG
Chunking, pencarian vektor
Tanya-jawab dari PDF kebijakan
8. Evaluasi
Uji, metrik, analisis kegagalan
Dasbor skor kualitas per versi prompt
9. Deploy
Keamanan, biaya, pemantauan
Fitur AI live di aplikasi sungguhan
Cara Mengatur Urutan Belajar Supaya Tidak Kewalahan
Bangun fondasi dulu (tahap 1 sampai 5). Jika kamu sudah bekerja sebagai developer, tahap ini bisa dipercepat dengan sekadar menutup celah, terutama Python dan dasar analisis data.
Buat satu proyek kecil yang memanggil model (tahap 6). Jangan menunggu merasa siap. Proyek pertama biasanya jelek, dan itu wajar.
Tambahkan data sendiri lewat RAG (tahap 7). Pakai dokumen yang kamu kenal isinya, supaya mudah menilai apakah jawabannya benar.
Pasang evaluasi sebelum menambah fitur (tahap 8). Tanpa evaluasi, kamu tidak tahu apakah perubahan membuat sistem lebih baik atau lebih buruk.
Deploy dan pantau (tahap 9). Dari pemakaian nyata kamu akan belajar hal-hal yang tidak ada di tutorial mana pun.
Kesalahan Umum Pemula di Jalur AI Engineering
Terlalu lama di teori. Menonton kursus berbulan-bulan tanpa membuat proyek membuat pemahaman tidak menempel.
Menganggap prompt sebagai satu-satunya keahlian. Data mencatat bahwa “prompt engineer” jarang berdiri sendiri sebagai jabatan, sementara kemampuan mengintegrasikan AI ke sistem lebih dicari.
Mengabaikan biaya. Pemanggilan model dihitung per token. Loop yang berjalan otomatis bisa membuat tagihan naik cepat.
Percaya pada demo. Sistem yang terlihat bagus pada tiga contoh belum tentu andal pada seratus kasus nyata.
Tidak mendokumentasikan proyek. Proyek yang tidak bisa dijelaskan dan diperlihatkan sulit membantumu mendapat pekerjaan.
Kapan Matematika dan Machine Learning Mulai Dibutuhkan?
Kamu akan mulai membutuhkan pemahaman yang lebih dalam ketika ingin melakukan fine-tuning, membangun model klasifikasi sendiri, memahami mengapa metrik tertentu menyesatkan, atau bekerja di tim riset. Pada titik itu, aljabar linear (vektor dan matriks), probabilitas, serta dasar optimasi akan sangat membantu. Karena kamu sudah punya fondasi rekayasa dan pengalaman nyata, belajar teori terasa lebih terarah: kamu tahu masalah apa yang ingin dipecahkan.
Mulai dari Satu Proyek Kecil Minggu Ini
Pilih satu ide sederhana, misalnya pengklasifikasi tiket atau tanya-jawab dari dokumen, lalu bangun dengan dokumentasi resmi sebagai pegangan. Setelah jadi, tampilkan hasilnya dengan rapi, panduannya ada di portofolio programmer dengan proyek AI agent.
Apakah benar AI engineering bisa dipelajari tanpa deep math?
Untuk peran yang berfokus pada membangun aplikasi dengan model yang sudah ada, ya, kamu bisa mulai tanpa matematika mendalam. Yang dibutuhkan terutama rekayasa perangkat lunak, data, dan evaluasi. Matematika baru menjadi keharusan jika kamu melatih atau menyesuaikan model.
Apakah harus bisa backend dulu sebelum belajar AI?
Tidak wajib, tetapi sangat membantu. Dengan backend, kamu paham request, database, dan pengujian, sehingga fitur AI yang kamu buat bisa benar-benar dipakai, bukan berhenti sebagai demo.
Berapa lama waktu belajar dari nol sampai bisa membuat fitur AI?
Tergantung latar belakang dan waktu yang tersedia. Seorang developer yang sudah paham backend bisa membuat prototipe berbasis API dalam beberapa minggu, sedangkan pemula total butuh waktu lebih lama untuk fondasi. Jangan memakai angka pasti sebagai patokan; ukur dari proyek yang selesai.
Lebih baik belajar Gemini API atau Claude API?
Keduanya punya konsep serupa: pesan, instruksi sistem, structured output, dan tool use. Pelajari satu dulu sampai lancar, lalu coba yang lain untuk membandingkan kualitas, kecepatan, dan biaya. Pilihan akhir sebaiknya mengikuti kebutuhan proyek.
RAG adalah teknik yang mencari potongan dokumen relevan lalu memberikannya kepada model sebagai konteks. Manfaatnya, jawaban bisa bersumber dari data terbaru atau data privat tanpa melatih ulang model, dan lebih mudah ditelusuri asalnya.
Bagaimana cara mengevaluasi output AI dengan sederhana?
Kumpulkan puluhan pertanyaan nyata beserta jawaban acuan, jalankan sistemmu, lalu nilai ketepatan, kesesuaian dengan sumber, format, latensi, dan biaya. Ulangi setiap kali kamu mengubah prompt atau model agar perubahan bisa dibandingkan.
Apakah AI akan menggantikan programmer sehingga belajar ini sia-sia?
Analisis yang menyilangkan beberapa laporan menempatkan profesi programmer sebagai “beradaptasi”, bukan “digantikan”. Pembahasannya ada di artikel apakah AI akan menggantikan programmer. Kemampuan membangun dan memverifikasi sistem berbasis AI justru menambah nilai.
Kesimpulan
Masuk ke AI engineering tidak menuntut kamu menaklukkan deep math di hari pertama. Jalur yang lebih realistis adalah membangun fondasi backend, API, SQL, analisis data, dan Python, lalu bergerak ke integrasi model, embedding, RAG, evaluasi, dan deploy. Setiap tahap menghasilkan sesuatu yang bisa kamu tunjukkan.
Wawasan yang sering terlewat: pembeda utama bukan siapa yang paling cepat memakai model terbaru, melainkan siapa yang bisa membuktikan sistemnya bekerja lewat evaluasi dan pemantauan. Mulailah dari proyek kecil, ukur hasilnya, dan perdalam teori ketika kebutuhan nyata menuntutnya. Pelan-pelan saja, tetapi konsisten.