Daftar Isi:
Kata “embedding” muncul di hampir setiap pembahasan chatbot dokumen, pencarian semantik, dan sistem rekomendasi. Namun bagi banyak orang, istilah ini terdengar seperti jargon matematika yang menakutkan. Padahal ide dasarnya cukup sederhana: mengubah teks menjadi deretan angka yang menyimpan maknanya, sehingga komputer bisa membandingkan “seberapa mirip arti” dua kalimat.
Artikel ini menjelaskan pengertian embedding, cara kerjanya, cara mengukur kemiripan, contoh kode sederhana, sampai perannya dalam RAG. Penjelasannya ditulis untuk pembaca umum, dengan detail teknis yang tetap berguna bagi developer dan profesional.
Embedding Adalah: Pengertian Singkat
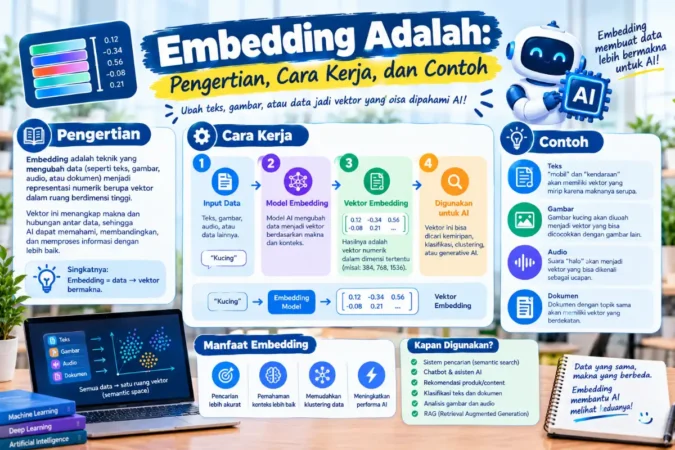
Embedding adalah representasi numerik dari data, misalnya teks, gambar, atau audio, dalam bentuk deretan angka yang disebut vektor. Data yang maknanya mirip akan menghasilkan vektor yang letaknya berdekatan, sedangkan data yang maknanya berbeda akan berjauhan.
Dokumentasi resmi Gemini API menjelaskan embedding sebagai representasi numerik yang memungkinkan tugas seperti pencarian semantik, klasifikasi, dan pengelompokan (clustering) dengan hasil yang lebih sadar konteks dibandingkan pencocokan kata kunci biasa. Halaman dokumentasi Google Cloud berbahasa Indonesia juga menyebut prinsip yang sama: makin dekat dua vektor di ruang embedding, makin besar kemiripan inputnya.
Analogi Sederhana: Peta Makna
Bayangkan sebuah peta besar tempat setiap kalimat ditandai sebagai satu titik. Kalimat “cara reset kata sandi akun” dan “lupa password, bagaimana masuk lagi” ditaruh berdekatan karena artinya serupa, walaupun tidak ada satu pun kata yang sama persis. Sebaliknya, “jadwal pertandingan sepak bola” ditaruh jauh dari keduanya.
Pencarian biasa berbasis kata kunci akan gagal menghubungkan dua kalimat pertama. Pencarian berbasis embedding bisa, karena yang dibandingkan adalah posisi di peta makna, bukan kesamaan huruf.
Pencarian kata kunciMencocokkan kata yang sama persis. Cepat, tetapi tidak paham sinonim.
Pencarian embeddingMembandingkan makna lewat jarak vektor. Paham sinonim dan parafrasa.
Pendekatan hibridaMenggabungkan keduanya, berguna untuk kode produk, nama, atau istilah khusus.
Cara Kerja Embedding
- Teks dimasukkan ke model embedding. Ini adalah model khusus yang dilatih untuk memetakan teks ke ruang vektor. Modelnya berbeda dari model chat, meskipun sering berasal dari penyedia yang sama.
- Model menghasilkan vektor. Keluarannya berupa daftar angka desimal dengan panjang tetap. Panjang itu disebut dimensi, misalnya ratusan hingga ribuan angka.
- Vektor disimpan. Biasanya disimpan bersama teks asli dan metadata di database vektor atau database yang mendukung pencarian vektor.
- Kemiripan dihitung. Saat ada pertanyaan, teks pertanyaan diubah menjadi vektor dengan model yang sama, lalu dibandingkan dengan vektor yang tersimpan.
Aturan penting: vektor hanya bisa dibandingkan jika dibuat oleh model embedding yang sama. Vektor dari dua model berbeda hidup di “peta” yang berbeda, sehingga hasil perbandingannya tidak bermakna. Jika Anda mengganti model embedding, seluruh data harus dibuat ulang vektornya.
Cosine Similarity: Cara Mengukur Kemiripan
Ukuran yang paling sering dipakai untuk membandingkan dua vektor adalah cosine similarity, yaitu sudut antara dua vektor. Nilainya berkisar dari -1 sampai 1. Nilai mendekati 1 berarti arahnya hampir sama (maknanya mirip), sekitar 0 berarti tidak berhubungan, dan negatif berarti berlawanan arah. Dokumentasi Gemini menyebut metrik ini cocok karena berfokus pada arah, bukan besar angkanya.
Berikut ilustrasi dengan vektor dua dimensi supaya mudah dibayangkan. Vektor sungguhan memiliki ratusan sampai ribuan dimensi, tetapi prinsipnya sama.
import math

def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(y * y for y in b))
    return dot / (na * nb)

kalimat_a = [1.0, 2.0]   # "reset kata sandi"
kalimat_b = [2.0, 4.0]   # "lupa password"
kalimat_c = [2.0, -1.0]  # "jadwal sepak bola"

print(cosine(kalimat_a, kalimat_b))  # 1.0  -> arah sama, sangat mirip
print(cosine(kalimat_a, kalimat_c))  # 0.0  -> tidak berhubungan
Angka pada contoh dibuat sendiri untuk ilustrasi, bukan keluaran model sungguhan. Untuk vektor asli, Anda cukup memanggil API embedding dari penyedia model, lalu memakai fungsi yang sama.
Baca Juga:
Contoh Pemakaian Embedding
Pencarian semantik
Mencari berdasarkan makna, bukan kata
Pengguna mengetik “laptop untuk desain grafis yang ringan” dan sistem menemukan artikel ulasan yang membahas “notebook kreator konten portabel”, meski kata-katanya tidak sama.
RAG
Menjadi mesin pencari untuk chatbot dokumen
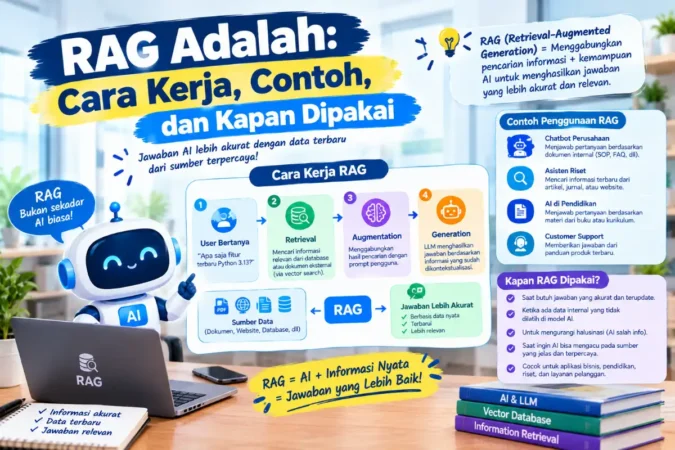
Dokumen dipecah menjadi potongan, tiap potongan diubah menjadi vektor, lalu potongan paling dekat dengan pertanyaan diambil untuk dijadikan konteks jawaban. Alur lengkapnya dijelaskan di artikel RAG adalah.
Klasifikasi dan pengelompokan
Mengelompokkan tiket, ulasan, atau artikel
Ribuan ulasan pelanggan dapat dikelompokkan otomatis berdasarkan topik, misalnya keluhan pengiriman, pembayaran, dan kualitas produk.
Rekomendasi dan deteksi duplikat
Menemukan konten atau pertanyaan yang serupa
Platform bisa merekomendasikan artikel sejenis atau mendeteksi pertanyaan ganda di forum walaupun redaksinya berbeda.
Memilih Model dan Dimensi Embedding
Pilihan model memengaruhi kualitas, biaya, dan kecepatan. Dokumentasi Gemini saat ini mencantumkan gemini-embedding-2 (multimodal, mendukung teks, gambar, video, audio, dan dokumen) dan gemini-embedding-001 (khusus teks). Keduanya menghasilkan vektor 3.072 dimensi secara bawaan dengan opsi dimensi yang lebih kecil. Nama dan spesifikasi model bisa berubah, jadi selalu cek dokumentasi resmi sebelum memutuskan.
| Pertimbangan | Yang perlu dicek |
|---|---|
| Dukungan bahasa | Uji dengan kalimat bahasa Indonesia, termasuk singkatan dan istilah teknis organisasi Anda |
| Dimensi vektor | Dimensi besar biasanya lebih rinci tetapi memakan penyimpanan dan waktu pencarian lebih banyak |
| Jenis data | Hanya teks, atau juga gambar, audio, dan dokumen |
| Biaya | Harga per juta token dan berapa sering data harus dibuat ulang |
| Konsistensi | Model untuk dokumen dan untuk pertanyaan harus sama |
Catatan kritis: skor benchmark embedding yang dipromosikan penyedia dibuat pada dataset tertentu, sering kali berbahasa Inggris. Cara paling jujur menilai adalah menguji dengan 30 sampai 50 pertanyaan nyata dari data Anda sendiri dan melihat apakah potongan yang benar muncul di hasil teratas.
Di Mana Embedding Disimpan?
Untuk data kecil, vektor bisa disimpan di file atau tabel biasa dan dibandingkan langsung. Untuk data besar, dipakai database vektor atau database yang menyediakan indeks pencarian vektor agar hasil muncul cepat. Beberapa layanan data warehouse juga mulai mendukung embedding. Contohnya, BigQuery memiliki dukungan model embedding Gemini di BigQuery ML. Bagi developer backend, pilihan paling praktis biasanya memulai dari database yang sudah dikuasai sebelum menambah komponen baru.
Keterbatasan Embedding
- Mirip belum tentu benar. Potongan yang dekat secara makna tidak selalu berisi jawaban yang tepat.
- Kurang tajam untuk hal yang sangat spesifik. Kode produk, nomor regulasi, atau nama orang sering lebih baik dicari dengan kata kunci biasa, atau gabungan keduanya.
- Sensitif terhadap cara memotong teks. Potongan yang terlalu panjang mengaburkan makna, yang terlalu pendek kehilangan konteks.
- Perlu dibuat ulang saat model diganti. Ini berdampak pada biaya dan waktu untuk data yang besar.
- Data sensitif tetap butuh perlindungan. Teks yang dikirim ke API embedding pihak ketiga tunduk pada kebijakan penyedia tersebut.
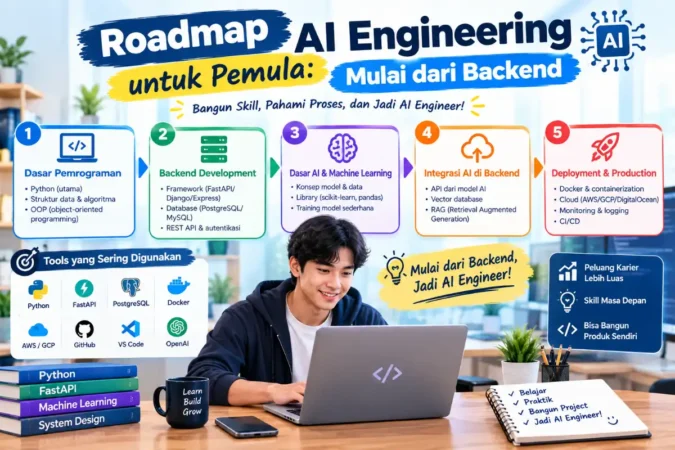
Jika Anda ingin melihat posisi embedding dalam jalur belajar yang utuh, dari backend sampai evaluasi dan deploy, baca roadmap AI engineering dari backend.
Coba Buat Embedding Pertama Anda
Ambil sepuluh kalimat FAQ yang Anda kuasai, buat vektornya lewat API, lalu hitung kemiripan dengan beberapa pertanyaan. Cara paling cepat memahami embedding adalah melihat sendiri kalimat mana yang dianggap “dekat”.
Dokumentasi Embedding Gemini Panduan Google CloudFAQ
Embedding adalah apa dalam bahasa sederhana?
Embedding adalah cara mengubah teks (atau gambar dan audio) menjadi deretan angka yang mewakili maknanya. Dengan angka itu, komputer bisa menghitung seberapa mirip arti dua data.
Baca Juga:
Apa bedanya embedding dengan vektor?
Vektor adalah bentuk datanya, yaitu deretan angka. Embedding adalah vektor yang dihasilkan model untuk mewakili makna suatu data. Jadi setiap embedding adalah vektor, tetapi tidak semua vektor adalah embedding.
Apa hubungan embedding dengan RAG?
Dalam RAG, embedding dipakai untuk mencari potongan dokumen yang paling relevan dengan pertanyaan. Potongan itu kemudian diberikan ke model bahasa sebagai bahan menjawab.
Apakah embedding sama dengan model bahasa seperti chatbot?
Tidak. Model embedding menghasilkan vektor untuk pencarian dan perbandingan, sedangkan model bahasa (LLM) menghasilkan teks jawaban. Keduanya sering dipakai bersama dalam satu sistem.
Apakah embedding mendukung bahasa Indonesia?
Banyak model embedding modern mendukung banyak bahasa, termasuk bahasa Indonesia. Meski begitu, kualitasnya berbeda-beda, jadi uji dengan data Anda sendiri sebelum dipakai di produksi.
Apa itu cosine similarity?
Cosine similarity adalah ukuran kemiripan dua vektor berdasarkan sudutnya. Nilainya antara -1 dan 1, dan makin mendekati 1 artinya makna kedua data makin mirip.
Apakah harus paham matematika untuk memakai embedding?
Tidak harus. Anda cukup memahami konsep bahwa vektor yang berdekatan berarti maknanya mirip. Perhitungan detail sudah ditangani pustaka dan API, sehingga fokus Anda lebih pada kualitas data dan pengujian.
Kesimpulan
Embedding adalah jembatan antara bahasa manusia dan komputasi: teks diubah menjadi vektor sehingga kemiripan makna bisa dihitung. Itulah yang memungkinkan pencarian semantik, pengelompokan data, rekomendasi, dan tentu saja RAG bekerja.
Wawasan yang sering terlewat: embedding bukan solusi ajaib, melainkan alat yang kualitasnya sangat bergantung pada pilihan model, cara memotong teks, dan pengujian dengan data nyata. Keputusan mengganti model embedding juga berarti membuat ulang seluruh vektor, jadi pilih dengan cermat sejak awal. Mulailah dari contoh kecil, ukur hasilnya, lalu skalakan.
Baca Juga: