Daftar Isi:
- RAG Adalah: Pengertian Singkat
- Kenapa RAG Dibutuhkan?
- Cara Kerja RAG Langkah demi Langkah
- Komponen Utama Sistem RAG
- Contoh Penggunaan RAG di Dunia Nyata
- RAG vs Fine-Tuning vs Prompt Biasa
- Kelebihan dan Keterbatasan RAG
- Tips Praktis Membuat RAG yang Andal
- FAQ
- RAG adalah singkatan dari apa?
- Apakah RAG bisa menghilangkan halusinasi AI?
- Apa bedanya RAG dengan fine-tuning?
- Apakah RAG butuh database vektor khusus?
- Apakah RAG bisa dipakai untuk dokumen berbahasa Indonesia?
- Apakah data saya aman saat memakai RAG?
- Apakah perlu belajar matematika dulu untuk membuat RAG?
- Kesimpulan
Pernahkah chatbot AI menjawab dengan yakin, tetapi ternyata salah? Atau menolak menjawab karena tidak tahu isi dokumen internal perusahaan Anda? Dua masalah itu, jawaban karangan dan pengetahuan yang usang atau tidak lengkap, adalah alasan utama lahirnya RAG.
Artikel ini menjelaskan apa itu RAG, bagaimana alurnya bekerja, di mana ia cocok dipakai, apa saja batasannya, serta bedanya dengan fine-tuning. Bahasanya dibuat bisa dipahami pembaca umum, tetapi tetap cukup teknis untuk developer dan profesional yang ingin membangun fitur AI sendiri.
RAG Adalah: Pengertian Singkat
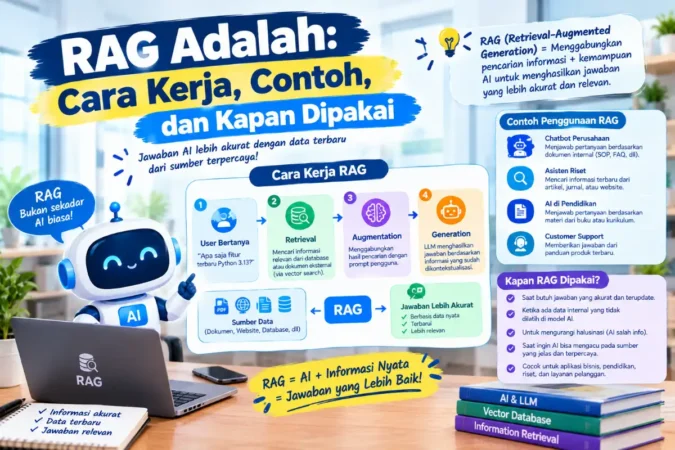
RAG (Retrieval-Augmented Generation) adalah teknik yang membuat model bahasa besar (LLM) mencari informasi relevan dari sumber data eksternal, seperti dokumen, basis pengetahuan, atau database, lalu memakai informasi itu sebagai konteks untuk menyusun jawaban. Model tidak hanya mengandalkan apa yang ia “hafal” saat dilatih.
Analogi sederhananya: ujian buku terbuka. Model biasa menjawab murni dari ingatan, sedangkan model dengan RAG boleh membuka buku catatan dulu sebelum menjawab. Hasilnya lebih relevan, lebih mudah ditelusuri sumbernya, dan tidak perlu melatih ulang model setiap kali dokumen berubah.
Istilah ini dipopulerkan lewat makalah “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” oleh Patrick Lewis dan rekan-rekannya (dipresentasikan di NeurIPS 2020). Peneliti menggabungkan dua jenis memori: memori parametrik (pengetahuan yang tertanam di bobot model) dan memori non-parametrik (indeks dokumen yang bisa dicari). Konsep dasar itu kini menjadi salah satu pola paling umum dalam aplikasi LLM di dunia kerja.
Kenapa RAG Dibutuhkan?
LLM punya tiga keterbatasan yang langsung terasa saat dipakai untuk pekerjaan nyata.
Batas pengetahuanModel hanya tahu data sampai tanggal pelatihannya, sehingga tidak mengenal kebijakan atau harga terbaru.
Tidak tahu data privatSOP, kontrak, dan FAQ internal tidak ada di data pelatihan model publik.
HalusinasiModel bisa menyusun jawaban yang terdengar meyakinkan padahal keliru.
RAG tidak menghapus halusinasi sepenuhnya, tetapi memberi model bahan yang bisa dirujuk. Jawaban dapat disertai kutipan sumber, sehingga pengguna atau tim QA bisa memeriksa dari mana klaim itu berasal.
Catatan kritis: banyak materi pemasaran menyebut RAG sebagai “obat halusinasi”. Kenyataannya, kualitas RAG sangat bergantung pada kualitas dokumen dan proses pencariannya. Jika dokumen sumber salah atau potongan yang diambil tidak relevan, model tetap bisa menjawab keliru dengan nada percaya diri. Pembahasan tentang basis pengetahuan yang minim juga muncul di ulasan Meta Business Agent Platform, yang memakai pendekatan mirip RAG.
Cara Kerja RAG Langkah demi Langkah
Alur RAG terdiri dari dua fase: persiapan data (dilakukan di awal dan saat dokumen berubah) dan pemrosesan pertanyaan (dilakukan setiap ada pengguna bertanya).
Fase 1: Menyiapkan Basis Pengetahuan
- Kumpulkan dokumen. Sumbernya bisa PDF, halaman web, catatan rapat, tiket layanan pelanggan, atau tabel database. Bersihkan teks dari header, footer, dan duplikasi.
- Pecah menjadi potongan (chunking). Dokumen panjang dibagi menjadi bagian-bagian kecil, misalnya per paragraf atau per subjudul, agar tiap potongan memuat satu gagasan yang utuh.
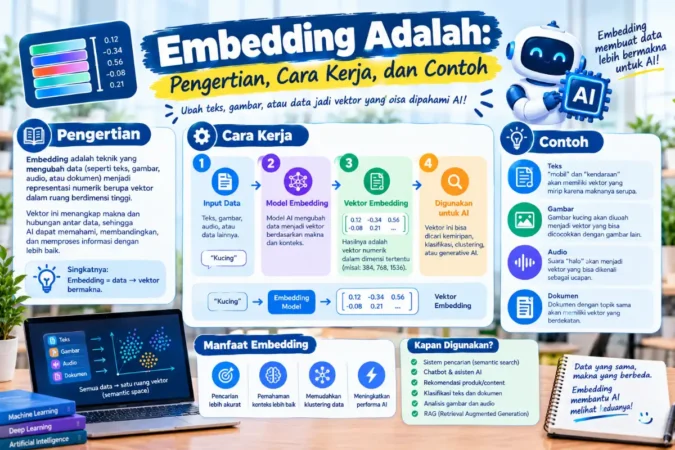
- Ubah menjadi embedding. Setiap potongan dikonversi oleh model embedding menjadi deretan angka (vektor) yang mewakili maknanya. Potongan dengan makna serupa akan berdekatan dalam ruang vektor. Penjelasan resmi tentang embedding tersedia di dokumentasi Google Cloud.
- Simpan di penyimpanan vektor. Vektor berikut teks aslinya dan metadata (judul, tanggal, sumber) disimpan di database vektor atau database biasa yang mendukung pencarian vektor.
Fase 2: Menjawab Pertanyaan
- Pertanyaan diubah menjadi embedding dengan model yang sama.
- Sistem mencari potongan terdekat (retrieval), biasanya beberapa hasil teratas berdasarkan kemiripan makna.
- Potongan disisipkan ke prompt bersama instruksi, misalnya “Jawab hanya berdasarkan konteks berikut, dan katakan tidak tahu jika jawabannya tidak ada.”
- LLM menyusun jawaban (generation), idealnya disertai rujukan ke potongan sumber.
Kerangka alurnya, dalam bentuk kode semu, kira-kira seperti ini:
Baca Juga:
pertanyaan = "Berapa hari cuti tahunan karyawan tetap?"

vektor_tanya = embed(pertanyaan)
potongan = cari_terdekat(vektor_tanya, top_k=4)

prompt = f"""Jawab hanya dari konteks. Jika tidak ada, katakan tidak tahu.
Konteks: {potongan}
Pertanyaan: {pertanyaan}"""

jawaban = llm(prompt)
Komponen Utama Sistem RAG
| Komponen | Fungsi | Yang sering jadi masalah |
|---|---|---|
| Sumber data | Dokumen yang menjadi rujukan jawaban | Dokumen usang, ganda, atau saling bertentangan |
| Chunking | Memecah dokumen menjadi potongan bermakna | Potongan terlalu pendek kehilangan konteks, terlalu panjang mengaburkan pencarian |
| Model embedding | Mengubah teks menjadi vektor | Model kurang kuat untuk bahasa Indonesia atau istilah teknis |
| Penyimpanan vektor | Menyimpan dan mencari vektor | Biaya, kecepatan, dan pembaruan data |
| Retriever | Memilih potongan paling relevan | Hasil mirip secara makna tetapi tidak menjawab pertanyaan |
| LLM (generator) | Menyusun jawaban dari konteks | Mengabaikan konteks atau menambah klaim di luar sumber |
Contoh Penggunaan RAG di Dunia Nyata
Layanan pelanggan
Chatbot yang menjawab dari FAQ dan kebijakan
Alih-alih menjawab generik, chatbot mengambil kebijakan pengembalian barang atau syarat garansi yang berlaku, lalu menjawab sesuai isi dokumen. Saat kebijakan berubah, cukup perbarui dokumennya.
Pengetahuan internal
Asisten SOP dan onboarding karyawan
Karyawan baru bertanya, “Bagaimana prosedur klaim biaya perjalanan dinas?” dan sistem mengambil bagian SOP yang relevan lengkap dengan rujukan halamannya.
Dokumentasi teknis
Tanya-jawab dari dokumentasi produk atau kode
Tim developer bisa bertanya tentang endpoint, konfigurasi, atau riwayat keputusan arsitektur tanpa membuka puluhan halaman wiki.
Riset dan pendidikan
Ringkasan dari kumpulan modul atau regulasi
Guru, mahasiswa, atau analis dapat menanyakan isi kumpulan modul dan regulasi, lalu memeriksa kutipan sumbernya sebelum memakainya.
RAG vs Fine-Tuning vs Prompt Biasa
Ketiganya sering dianggap saingan, padahal menjawab kebutuhan yang berbeda. RAG cocok untuk menambah pengetahuan yang sering berubah, sedangkan fine-tuning lebih cocok untuk mengubah gaya, format, atau perilaku model.
| Aspek | Prompt biasa | RAG | Fine-tuning |
|---|---|---|---|
| Cara kerja | Semua informasi ditulis di prompt | Informasi diambil otomatis dari basis pengetahuan | Bobot model disesuaikan dengan data latihan |
| Data sering berubah | Repot, harus ditempel manual | Cocok, cukup perbarui dokumen | Kurang cocok, perlu pelatihan ulang |
| Data besar | Terbatas ukuran konteks | Cocok | Bisa, tetapi mahal |
| Bisa menunjukkan sumber | Bergantung penulis prompt | Mudah | Sulit |
| Cocok untuk | Tugas sederhana dan sekali pakai | Tanya-jawab dari dokumen | Mengubah gaya atau format keluaran |
Ukuran model juga memengaruhi pilihan. Model kecil yang dipadukan dengan RAG kadang cukup untuk tanya-jawab dokumen, dan pembahasan kelebihannya ada di artikel model AI kecil vs besar.
Kelebihan dan Keterbatasan RAG
Kelebihan
- Pengetahuan mudah diperbarui tanpa melatih ulang model.
- Jawaban dapat disertai rujukan sumber sehingga lebih mudah diaudit.
- Data privat tetap berada di sistem Anda dan hanya potongan relevan yang dikirim ke model.
- Biayanya umumnya lebih terjangkau daripada melatih atau menyesuaikan model.
Keterbatasan
- Kualitas jawaban bergantung pada kualitas dokumen dan pencarian, bukan hanya pada model.
- Pertanyaan yang butuh penalaran lintas banyak dokumen sekaligus lebih sulit ditangani.
- Ada biaya tambahan: embedding, penyimpanan, dan konteks yang makin panjang di setiap permintaan.
- Risiko keamanan seperti prompt injection lewat isi dokumen. Daftar risiko umum tersedia di OWASP Top 10 untuk aplikasi LLM.
Tips Praktis Membuat RAG yang Andal
- Mulai dari dokumen yang Anda kenal isinya. Dengan begitu Anda bisa menilai jawaban benar atau tidak.
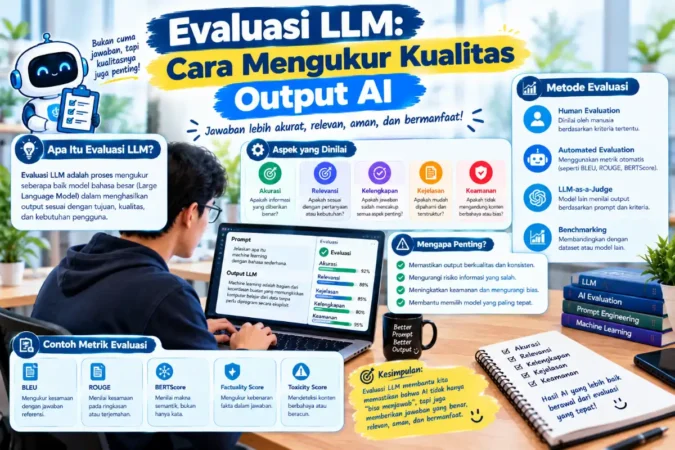
- Uji dengan daftar pertanyaan nyata. Siapkan 30 sampai 50 pertanyaan beserta jawaban acuan, lalu jalankan ulang setiap kali mengubah ukuran chunk, model, atau prompt.
- Perintahkan model untuk mengaku tidak tahu. Instruksi ini mengurangi jawaban karangan saat konteks tidak memadai.
- Simpan metadata. Judul, tanggal, dan sumber memudahkan penyaringan dan pencantuman kutipan.
- Jaga kebersihan data. Hapus versi lama dokumen agar model tidak mengutip aturan yang sudah tidak berlaku.
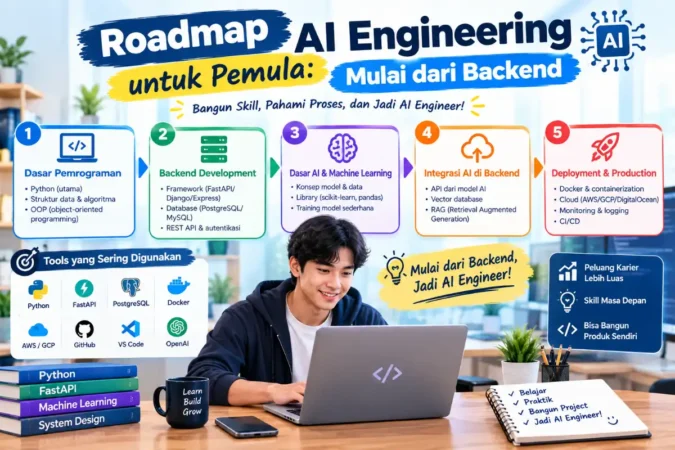
Jika Anda ingin melihat posisi RAG dalam perjalanan belajar AI engineering secara utuh, mulai dari backend, database, sampai evaluasi dan deploy, baca roadmap AI engineering dari backend.
Coba Bangun RAG Kecil Sendiri
Pilih satu dokumen yang Anda kuasai, misalnya kebijakan cuti atau FAQ produk, lalu buat versi tanya-jawabnya. Untuk memahami komponen embedding yang menjadi dasarnya, mulailah dari dokumentasi resmi berikut.
Dokumentasi Embedding Google Cloud Makalah RAG AsliFAQ
RAG adalah singkatan dari apa?
RAG adalah singkatan dari Retrieval-Augmented Generation, yaitu teknik “menghasilkan jawaban yang diperkaya hasil pencarian”. Sistem mencari informasi relevan dulu, lalu model bahasa menyusun jawaban berdasarkan informasi itu.
Apakah RAG bisa menghilangkan halusinasi AI?
Tidak sepenuhnya. RAG mengurangi risiko karena model punya rujukan, tetapi jawaban tetap bisa keliru jika dokumen sumber salah, pencarian mengambil potongan yang tidak relevan, atau model mengabaikan konteks. Karena itu evaluasi tetap diperlukan.
Baca Juga:
Apa bedanya RAG dengan fine-tuning?
RAG menambah pengetahuan lewat pencarian dokumen saat pertanyaan datang, sehingga cocok untuk data yang sering berubah. Fine-tuning menyesuaikan bobot model agar perilaku atau gayanya berubah. Keduanya bisa dikombinasikan, tetapi kebutuhan dan biayanya berbeda.
Apakah RAG butuh database vektor khusus?
Tidak selalu. Untuk data kecil sampai menengah, database relasional yang mendukung pencarian vektor bisa cukup. Database vektor khusus lebih relevan saat skala data besar atau kebutuhan pencarian semakin kompleks.
Apakah RAG bisa dipakai untuk dokumen berbahasa Indonesia?
Bisa, asalkan model embedding dan LLM yang dipilih mendukung bahasa Indonesia dengan baik. Uji dengan pertanyaan nyata, termasuk istilah teknis dan singkatan yang biasa dipakai di organisasi Anda.
Apakah data saya aman saat memakai RAG?
Data tetap berada di sistem Anda, tetapi potongan yang diambil dikirim ke model saat menjawab. Periksa kebijakan penyedia layanan, batasi akses dokumen sesuai hak pengguna, dan jangan memasukkan data sensitif tanpa perlindungan yang jelas.
Apakah perlu belajar matematika dulu untuk membuat RAG?
Tidak. Untuk membangun RAG dengan model yang sudah tersedia lewat API, Anda lebih membutuhkan kemampuan backend, pengolahan data, dan evaluasi. Pemahaman konsep kemiripan vektor sudah cukup sebagai bekal awal.
Kesimpulan
RAG adalah cara praktis menghubungkan model bahasa dengan pengetahuan yang benar-benar Anda miliki: dokumen dicari lebih dulu, lalu dipakai sebagai bahan jawaban. Pendekatan ini memperbarui pengetahuan tanpa pelatihan ulang dan memungkinkan jawaban disertai sumber.
Wawasan yang sering terlewat: keberhasilan RAG lebih ditentukan oleh kerapian dokumen, strategi chunking, dan evaluasi berkala daripada oleh model yang paling canggih. Mulailah dari kumpulan dokumen kecil yang isinya Anda kuasai, ukur kualitasnya dengan pertanyaan nyata, dan perbaiki bagian pencarian sebelum mengganti model. Dengan cara itu, RAG berubah dari sekadar demo menarik menjadi fitur yang bisa dipercaya pengguna.