Daftar Isi:
- Apa Itu Token dan Kenapa Dihitung?
- Rumus Biaya per Permintaan
- Contoh 1: Satu Tanya-Jawab dengan RAG
- Contoh 2: Percakapan Panjang yang Riwayatnya Dikirim Ulang
- Contoh 3: Agen yang Bekerja Bertahap
- Penyebab Tagihan Membengkak
- Cara Menekan Biaya Tanpa Merusak Kualitas
- Menyiapkan Anggaran yang Realistis
- FAQ
- Apa itu token pada LLM?
- Bagaimana cara menghitung biaya API LLM?
- Kenapa token keluar lebih mahal dari token masuk?
- Apakah 1 kata sama dengan 1 token?
- Kenapa tagihan API saya jauh lebih besar dari perkiraan?
- Bagaimana cara menghemat biaya tanpa menurunkan kualitas?
- Berapa anggaran bulanan yang perlu disiapkan?
- Kesimpulan
Prototipe fitur AI biasanya murah sekali. Anda mencoba beberapa kali, tagihannya hanya beberapa ribu rupiah, lalu Anda merasa aman. Masalahnya baru muncul saat pengguna sungguhan datang: percakapan makin panjang, dokumen yang disisipkan makin banyak, dan tiba-tiba tagihan bulanan berlipat ganda tanpa ada yang tahu sebabnya.
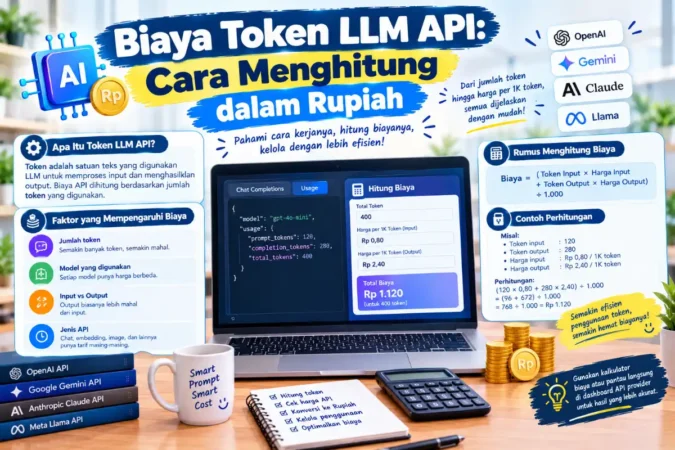
Artikel ini membahas cara menghitung biaya token API LLM dalam rupiah untuk aplikasi Anda sendiri. Anda akan mendapatkan rumus sederhana, tiga contoh hitungan (tanya-jawab, percakapan panjang, dan agen bertahap), penyebab tagihan membengkak, serta cara menekannya tanpa merusak kualitas.
Apa Itu Token dan Kenapa Dihitung?
Token adalah potongan teks yang diproses model, bisa berupa satu kata, sebagian kata, atau tanda baca. Penyedia API menghitung biaya berdasarkan jumlah token yang masuk (prompt Anda) dan yang keluar (jawaban model).
Dua hal penting yang sering terlewat. Pertama, harga token masuk dan token keluar biasanya berbeda, dan token keluar umumnya lebih mahal per satuannya. Kedua, jumlah token tidak sama dengan jumlah kata. Teks berbahasa Indonesia cenderung memakai lebih banyak token per kata dibanding bahasa Inggris pada banyak model, jadi ukur dengan penghitung token dari penyedia yang Anda pakai, bukan menebak dari jumlah kata.
Rumus Biaya per Permintaan
Rumusnya sederhana:
Biaya = (token masuk ÷ 1 juta × harga masuk) + (token keluar ÷ 1 juta × harga keluar), lalu dikalikan kurs jika harga dalam dolar.
Kode Python berikut menerapkan rumus itu. Harga dan kurs di dalamnya adalah angka contoh, bukan tarif resmi penyedia mana pun. Ganti dengan harga terbaru dari halaman resmi model yang Anda pakai.
KURS = 16500          # contoh: Rp per USD, ganti dengan kurs yang berlaku
HARGA_MASUK = 0.50    # contoh: USD per 1 juta token masuk
HARGA_KELUAR = 2.00   # contoh: USD per 1 juta token keluar

def biaya_rupiah(token_masuk, token_keluar,
                 harga_masuk=HARGA_MASUK, harga_keluar=HARGA_KELUAR, kurs=KURS):
    usd = (token_masuk / 1_000_000 * harga_masuk
           + token_keluar / 1_000_000 * harga_keluar)
    return usd * kurs
Contoh 1: Satu Tanya-Jawab dengan RAG
Bayangkan chatbot layanan pelanggan yang memakai RAG. Dalam satu permintaan, token masuknya terdiri dari instruksi sistem sekitar 500 token, potongan dokumen hasil pencarian sekitar 800 token, dan pertanyaan pengguna sekitar 200 token. Jawaban model sekitar 300 token.
| Komponen | Token |
|---|---|
| Instruksi sistem | 500 masuk |
| Konteks dokumen (RAG) | 800 masuk |
| Pertanyaan pengguna | 200 masuk |
| Jawaban model | 300 keluar |
| Total | 1.500 masuk, 300 keluar |
Rp22per permintaan dengan harga dan kurs contoh
Rp222.750untuk 10.000 permintaan per bulan
Rp2,2 jutauntuk 100.000 permintaan per bulan
Angka sebesar itu tampak murah, dan memang begitu untuk satu tanya-jawab. Justru inilah yang membuat orang lengah. Biaya sesungguhnya muncul dari cara aplikasi Anda memakai model, seperti dua contoh berikut.
Contoh 2: Percakapan Panjang yang Riwayatnya Dikirim Ulang
Model tidak “mengingat” percakapan di sisi Anda. Pada banyak desain, aplikasi mengirim ulang seluruh riwayat setiap kali pengguna membalas. Anggap tiap giliran menambah 500 token riwayat (200 pertanyaan dan 300 jawaban), dengan instruksi dan konteks yang sama seperti sebelumnya. Untuk percakapan 10 giliran:
Baca Juga:
- Total token masuk mencapai 37.500 dan token keluar 3.000.
- Biaya sekitar Rp408 per percakapan, atau rata-rata Rp41 per giliran, hampir dua kali lipat giliran pertama yang Rp22.
- Untuk 1.000 percakapan seperti itu, biayanya sekitar Rp408.000.
Pola ini tumbuh makin cepat seiring panjang percakapan, karena setiap giliran membawa seluruh riwayat sebelumnya. Jika riwayat dipangkas hanya ke dua giliran terakhir, total token masuk turun menjadi 23.500 dan biaya menjadi sekitar Rp293 per percakapan, atau hemat sekitar 28 persen. Tentu ada harga yang dibayar: model bisa lupa hal yang disebut di awal, jadi pangkas dengan bijak, misalnya dengan meringkas bagian lama.
Contoh 3: Agen yang Bekerja Bertahap
Agen AI menyelesaikan tugas lewat beberapa langkah, dan tiap langkah biasanya membawa konteks yang makin membesar. Misalkan agen bekerja delapan langkah, mulai dari konteks 2.000 token, dengan tiap langkah menghasilkan 400 token dan menambah 600 token hasil alat ke konteks. Totalnya sekitar 44.000 token masuk dan 3.200 token keluar, atau sekitar Rp469 per tugas. Itu kira-kira 21 kali biaya satu tanya-jawab biasa. Cara kerja loop agen dibahas di artikel cara kerja AI agent programming, dan pola inilah yang membuat tagihan naik tajam pada sistem agentik tanpa batas langkah.
Ingat: angka di atas memakai harga dan kurs contoh serta jumlah token yang disederhanakan. Biaya nyata Anda bergantung pada model, harga terbaru, kurs, dan panjang teks sebenarnya. Pakai contoh ini untuk memahami pola, bukan untuk menganggarkan.
Penyebab Tagihan Membengkak
1
Instruksi sistem yang panjang
Instruksi 2.000 token dikirim di setiap permintaan. Dikali ratusan ribu permintaan, ini jadi biaya tetap yang besar.
2
Konteks RAG terlalu banyak
Mengambil sepuluh potongan dokumen padahal tiga sudah cukup menggandakan token masuk tanpa tentu menaikkan kualitas.
3
Riwayat percakapan menumpuk
Seperti contoh 2, riwayat yang dikirim penuh membuat biaya per giliran terus naik.
4
Jawaban terlalu panjang
Karena token keluar lebih mahal, jawaban bertele-tele dua kali lipat lebih boros daripada yang terlihat.
5
Percobaan ulang dan loop tanpa batas
Validasi yang gagal lalu mengulang, atau agen yang tak berhenti, bisa melipatgandakan biaya per permintaan tanpa disadari.
Cara Menekan Biaya Tanpa Merusak Kualitas
- Ukur dulu sebelum menghemat. Catat token masuk, token keluar, dan biaya tiap permintaan. Tanpa data, penghematan hanya tebakan.
- Ringkas instruksi sistem. Hapus kalimat yang tidak mengubah perilaku model. Uji dengan dataset evaluasi supaya kualitasnya tidak turun. Caranya dibahas di evaluasi LLM.
- Batasi konteks RAG. Uji berapa potongan yang benar-benar dibutuhkan, lalu tetapkan jumlah terkecil yang menjaga mutu jawaban.
- Pangkas atau ringkas riwayat. Simpan beberapa giliran terakhir dan ringkasan bagian lama.
- Atur panjang keluaran. Tetapkan batas token keluar dan minta format ringkas, atau gunakan keluaran terstruktur seperti pada structured output LLM.
- Pilih model sesuai tugas. Tugas sederhana seperti klasifikasi sering cukup dengan model yang lebih kecil dan murah. Sisihkan model besar untuk kasus sulit. Perbandingannya ada di model AI kecil vs besar.
- Manfaatkan fitur hemat dari penyedia. Banyak penyedia menawarkan penyimpanan sementara (cache) untuk bagian prompt yang berulang atau pemrosesan massal untuk tugas yang tidak mendesak. Syarat dan potongan harganya berbeda-beda, jadi baca dokumentasi harga resminya.
- Pasang batas dan peringatan. Tetapkan kuota per pengguna, batas langkah untuk agen, dan alarm saat biaya harian melewati ambang.
Catatan kritis: penghematan yang terlalu agresif bisa menurunkan kualitas dan justru merugikan. Model murah yang sering salah menambah biaya tersembunyi: keluhan pengguna, kerja ulang, dan hilangnya kepercayaan. Ukur biaya dan kualitas bersamaan, lalu pilih titik terbaik untuk kebutuhan Anda.
Menyiapkan Anggaran yang Realistis
Untuk merencanakan anggaran bulanan, perkirakan jumlah permintaan atau percakapan per bulan, kalikan dengan biaya rata-rata dari data uji, lalu tambahkan cadangan 30 sampai 50 persen untuk lonjakan pemakaian, percobaan ulang, dan perubahan harga. Jangan lupa memperhitungkan fluktuasi kurs serta kemungkinan biaya tambahan dari pembayaran kartu atau pajak. Jika Anda baru mulai memanggil model dari kode, lihat panduan menggunakan Gemini API dengan Python, dan untuk gambaran keseluruhan jalur belajar, baca roadmap AI engineering dari backend.
Baca Juga:
Cek Harga Resmi Sebelum Menghitung
Harga per juta token berbeda antarmodel dan bisa berubah. Ambil angka terbaru dari halaman resmi, lalu masukkan ke fungsi hitung di atas. Sebagai pembanding, lihat juga contoh rincian biaya produk agen dalam rupiah.
Halaman Harga Vertex AI Contoh Rincian Biaya dalam RupiahFAQ
Apa itu token pada LLM?
Token adalah potongan teks yang diproses model, bisa berupa kata, sebagian kata, atau tanda baca. Biaya API dihitung dari jumlah token yang masuk dan keluar.
Bagaimana cara menghitung biaya API LLM?
Kalikan token masuk dengan harga masuk per juta token, tambahkan token keluar dikali harga keluar per juta token, lalu konversikan ke rupiah dengan kurs yang berlaku. Contoh kode ada di artikel ini.
Kenapa token keluar lebih mahal dari token masuk?
Pada banyak penyedia, menghasilkan teks membutuhkan komputasi lebih besar daripada membaca teks, sehingga harga per token keluar umumnya lebih tinggi. Cek daftar harga penyedia Anda karena rasionya berbeda-beda.
Apakah 1 kata sama dengan 1 token?
Tidak. Satu kata bisa menjadi satu atau beberapa token, dan teks bahasa Indonesia cenderung memakai lebih banyak token per kata pada banyak model. Gunakan penghitung token dari penyedia untuk hasil yang akurat.
Kenapa tagihan API saya jauh lebih besar dari perkiraan?
Penyebab yang umum adalah instruksi sistem yang panjang, konteks RAG yang terlalu banyak, riwayat percakapan yang dikirim ulang penuh, jawaban yang terlalu panjang, serta loop atau percobaan ulang yang tidak dibatasi. Catat token per permintaan untuk menemukan sumbernya.
Bagaimana cara menghemat biaya tanpa menurunkan kualitas?
Ukur dulu, lalu ringkas instruksi, batasi konteks RAG, pangkas riwayat, atur panjang keluaran, pilih model sesuai tugas, dan manfaatkan fitur hemat dari penyedia. Setelah tiap perubahan, jalankan evaluasi agar kualitas tetap terjaga.
Berapa anggaran bulanan yang perlu disiapkan?
Tidak ada angka universal. Hitung dari perkiraan jumlah permintaan dikali biaya rata-rata per permintaan hasil uji, lalu tambahkan cadangan untuk lonjakan dan perubahan harga.
Kesimpulan
Biaya token bukan misteri: ia hanya jumlah token masuk dan keluar dikali harga per juta token, lalu dikonversi ke rupiah. Yang sering mengejutkan bukan harga per token, melainkan pola pemakaian, terutama riwayat yang dikirim ulang, konteks yang membengkak, dan loop agen yang tidak dibatasi.
Wawasan yang sering terlewat: biaya per permintaan yang kecil menipu. Satu tanya-jawab bernilai Rp22 bisa berubah menjadi ratusan rupiah pada percakapan panjang atau tugas agen, dan bisa jadi jutaan rupiah saat dikali pengguna nyata. Ukur token sejak hari pertama, pasang batas dan peringatan, dan selalu timbang biaya bersama kualitas. Dengan begitu fitur AI Anda tetap berkelanjutan saat pengguna bertambah.
Baca Juga: