Daftar Isi:
Model Routing dan Fallback: Kapan Pindah Model Otomatis
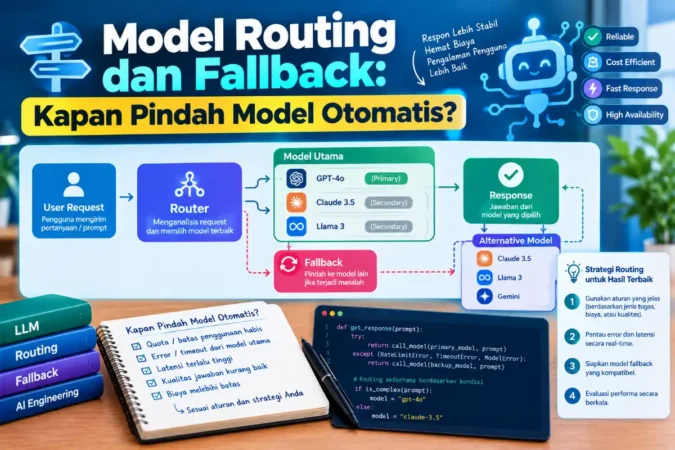
Tidak semua permintaan butuh model paling mumpuni dan paling mahal. Model routing mencoba model yang lebih murah/cepat dulu, dan hanya beralih ke model yang lebih mumpuni saat benar-benar dibutuhkan — baik karena model pertama gagal, atau hasilnya tidak memenuhi standar kualitas minimum. Berikut pola dan kodenya, diuji sampai ke skenario semua model gagal.
Kalau aplikasi Anda memanggil LLM untuk berbagai jenis tugas — klasifikasi sederhana, ringkasan singkat, sampai penalaran yang kompleks — memakai satu model paling mumpuni untuk semuanya berarti membayar harga premium untuk tugas yang sebenarnya bisa dijawab model yang jauh lebih murah. Model routing menjawab ini dengan mencoba model termurah dulu, dan hanya naik tingkat kalau diperlukan.
Dua Alasan untuk Fallback: Gagal atau Kurang Bagus
Ada dua pemicu berbeda yang sering disatukan padahal perlu ditangani terpisah:
| Pemicu fallback | Contoh | Cara deteksi |
|---|---|---|
| Error teknis | Timeout, rate limit 429, koneksi gagal | Exception yang dilempar SDK |
| Kualitas tidak cukup | Output kosong, terlalu pendek, gagal validasi format | Fungsi validator kustom terhadap hasil |
Kode Router: Coba Berurutan, Validasi Tiap Hasil
class SemuaModelGagal(Exception):
    pass

class RouterModel:
    def __init__(self, daftar_model_berurutan, validator_kualitas=None):
        # daftar_model_berurutan: dari yang paling murah/cepat ke paling mumpuni
        self.daftar_model = daftar_model_berurutan
        self.validator_kualitas = validator_kualitas or (lambda hasil: True)
        self.riwayat_percobaan = []

    async def panggil(self, prompt):
        self.riwayat_percobaan = []
        for nama_model, fungsi in self.daftar_model:
            try:
                hasil = await fungsi(prompt)
                if self.validator_kualitas(hasil):
                    self.riwayat_percobaan.append((nama_model, "berhasil"))
                    return hasil, nama_model
                self.riwayat_percobaan.append((nama_model, "kualitas_tidak_cukup"))
            except Exception as e:
                self.riwayat_percobaan.append((nama_model, f"error:{type(e).__name__}"))
        raise SemuaModelGagal(f"Semua model gagal: {self.riwayat_percobaan}")
Pemakaian: router = RouterModel([("murah", panggil_model_murah), ("mahal", panggil_model_mahal)], validator_kualitas=lambda h: len(h) >= 20). Router mencoba model pertama, memvalidasi hasilnya, dan hanya lanjut ke model berikutnya kalau gagal atau tidak lolos validasi.
Empat Skenario yang Diuji
1. Model murah cukup, tidak perlu fallback. Diuji: model murah mengembalikan jawaban yang lolos validator panjang minimum. Hasilnya langsung dipakai — model mahal tidak pernah dipanggil sama sekali, dikonfirmasi lewat
riwayat_percobaan yang hanya berisi satu entri.
2. Fallback saat model murah error. Diuji: model murah melempar
ConnectionError (mensimulasikan rate limit/overload). Router otomatis lanjut ke model mahal, yang berhasil. Riwayat percobaan mencatat keduanya dengan jelas: error:ConnectionError lalu berhasil.
3. Fallback saat kualitas model murah tidak cukup. Diuji: model murah tidak error, tapi hasilnya terlalu pendek (“ok”) dan gagal validator. Router tetap lanjut ke model mahal meski tidak ada exception — pemicu fallback berbasis kualitas bekerja terpisah dari pemicu berbasis error.
4. Semua model gagal, exception jelas. Diuji: kedua model dalam daftar gagal. Router melempar
SemuaModelGagal dengan riwayat lengkap percobaan tiap model tercatat di pesan error — memudahkan debugging kenapa permintaan gagal total, bukan sekadar “terjadi error”.
Simulasi Penghematan Biaya
Untuk menunjukkan skala dampaknya, berikut simulasi dengan angka ilustratif (bukan harga vendor sungguhan): model murah Rp0,10/1000 token, model mahal 15x lebih mahal di Rp1,50/1000 token, 10.000 permintaan dengan rata-rata 500 token, dan asumsi 85% permintaan sudah cukup dijawab model murah.
Rp7.500Tanpa routing (selalu model mahal)
Rp1.625Dengan routing (85% cukup model murah)
78%Penghematan
Perhitungan ini mengasumsikan biaya model murah tetap dibayar untuk semua permintaan (karena semua tetap mencoba model murah lebih dulu), ditambah biaya model mahal hanya untuk 15% yang fallback. Semakin tinggi persentase permintaan yang cukup dijawab model murah, semakin besar penghematannya — tapi ini juga berarti persentase itu perlu diukur dari data nyata aplikasi Anda, bukan diasumsikan.
Merancang Validator Kualitas yang Tepat
Trade-off yang perlu disadari: validator yang terlalu longgar membuat model murah “lolos” untuk kasus yang sebenarnya butuh model lebih mumpuni — pengguna mendapat jawaban buruk tanpa fallback terpicu. Validator yang terlalu ketat membuat hampir semua permintaan fallback ke model mahal, menghilangkan penghematan biaya yang jadi tujuan awal routing.
Validator yang baik biasanya kombinasi dari beberapa sinyal murah dihitung: panjang minimum/maksimum output, kecocokan dengan skema yang diharapkan (validasi berbasis skema seperti Pydantic bisa dipakai di sini), atau skor kepercayaan diri model itu sendiri kalau vendor menyediakannya. Menambahkan panggilan ke model lain hanya untuk “menilai” kualitas jawaban model murah biasanya kontraproduktif — biaya menilai bisa lebih mahal dari penghematan yang didapat.
Penting juga membedakan validator generik (panjang, format) dari validator spesifik-tugas. Untuk tugas klasifikasi, validator bisa memeriksa apakah label yang dikembalikan memang ada dalam daftar kategori yang valid. Untuk ringkasan, validator panjang minimum seperti contoh di atas sudah cukup memadai. Untuk ekstraksi data terstruktur, validasi skema penuh (memastikan semua field wajib terisi dengan tipe yang benar) adalah pilihan yang jauh lebih andal dibanding sekadar mengecek panjang string.
Pertanyaan yang Sering Muncul
Apakah model routing sama dengan load balancing?
Berbeda tujuan. Load balancing membagi trafik ke beberapa instance model yang setara untuk skalabilitas. Model routing memilih model yang berbeda kemampuan dan harganya berdasarkan kebutuhan tiap permintaan — tujuannya efisiensi biaya dan ketahanan, bukan pembagian beban semata.
Bagaimana kalau model murah dan mahal punya format output yang beda?
Normalisasi output ke bentuk yang konsisten sebelum masuk ke validator dan sebelum dikembalikan ke pemanggil — lapisan ini sebaiknya jadi bagian dari fungsi panggil masing-masing model di dalam daftar_model_berurutan, bukan ditangani di level router.
Baca Juga:
Apakah urutan model dalam daftar bisa lebih dari dua?
Bisa — pola di atas mendukung berapa pun jumlah model dalam rantai, dicoba berurutan sampai salah satu berhasil dan lolos validasi. Tiga tingkat (murah, menengah, mumpuni) cukup umum dipakai untuk aplikasi dengan variasi kompleksitas permintaan yang tinggi.
Apakah fallback menambah latensi untuk kasus yang gagal?
Ya — permintaan yang fallback menunggu model pertama gagal/ditolak dulu sebelum mencoba model berikutnya, sehingga latensi totalnya lebih tinggi dari langsung memanggil model mahal. Ini trade-off yang wajar untuk mayoritas kasus yang tidak fallback, tapi perlu diperhitungkan dalam metrik p95 latensi aplikasi secara keseluruhan — permintaan yang fallback akan muncul sebagai outlier latensi yang perlu dipantau terpisah dari rata-rata.
Apakah router perlu tahu status “kesehatan” model sebelum mencoba?
Untuk kasus sederhana, tidak perlu — router yang mencoba lalu menangkap error sudah cukup. Untuk trafik tinggi, menambahkan circuit breaker (menghindari mencoba model yang baru saja gagal berkali-kali) bisa menghemat latensi karena tidak perlu menunggu timeout dari model yang sedang jelas bermasalah sebelum fallback.
Kesimpulan
Model routing memberi kontrol biaya tanpa mengorbankan kualitas jawaban yang benar-benar butuh model mumpuni — asalkan pemicu fallback dirancang dengan benar, terpisah antara kegagalan teknis dan kualitas yang tidak cukup. Pengujian di atas mengonfirmasi router bekerja sesuai desain di keempat skenario: hemat saat model murah cukup, otomatis naik tingkat saat gagal atau kualitas kurang, dan gagal dengan jelas (bukan diam-diam) saat semua opsi habis. Simulasi biaya menunjukkan potensi penghematan besar, tapi angka pastinya hanya bisa didapat dari mengukur persentase permintaan yang benar-benar cukup dijawab model murah di aplikasi Anda sendiri.
Artikel terkait: structured output LLM dan monitoring aplikasi AI (untuk memantau dampak fallback pada p95 latensi).
Mau menghitung biaya token secara detail?
Baca cara menghitung biaya token LLM API dalam rupiah, termasuk perbandingan skenario penggunaan.
Baca Selengkapnya