Daftar Isi:
Job Queue Async untuk Tugas AI yang Lama: Pola dan Kode
Sebagian tugas AI tidak cocok dijawab langsung dalam satu request-response: memproses dokumen panjang, generate laporan multi-halaman, atau memanggil model berkali-kali dalam satu alur kerja. Endpoint yang menunggu semua itu selesai berarti pengguna menatap loading spinner terlalu lama. Ini pola queue-worker yang memisahkan keduanya, diuji sampai ke soal ketahanan saat satu job gagal.
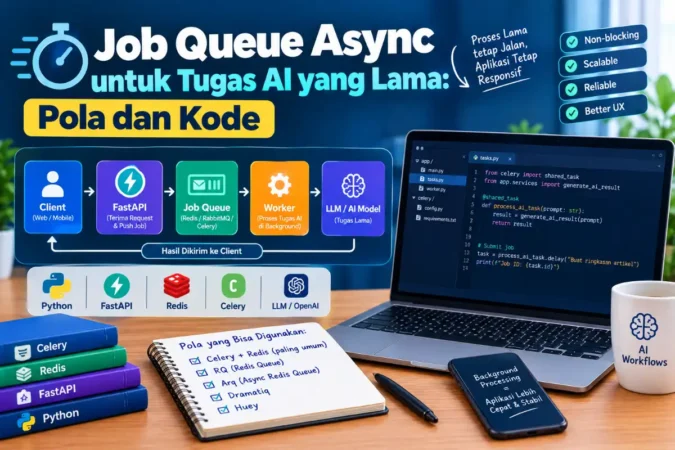
Kalau Anda sudah membaca artikel FastAPI untuk aplikasi AI, bagian BackgroundTasks di sana cocok untuk tugas ringan seperti logging. Untuk tugas yang benar-benar lama — bisa puluhan detik sampai beberapa menit, seperti memproses dokumen besar lewat beberapa tahap RAG atau menjalankan alur agent multi-langkah — pola yang lebih tepat adalah job queue: endpoint langsung mengembalikan ID job begitu tugas diterima, worker terpisah yang mengerjakannya, dan endpoint lain untuk mengecek statusnya.
Kenapa Bukan Cukup Menunggu di Endpoint Saja
Timeout HTTP
Banyak load balancer dan reverse proxy punya batas waktu default (30-60 detik). Tugas yang lebih lama dari itu akan terputus di tengah jalan, meski prosesnya di backend sebenarnya masih berjalan.
Koneksi yang terbuka lama
Menahan satu koneksi HTTP terbuka selama beberapa menit memboroskan resource server untuk sesuatu yang sebenarnya bisa dicek secara berkala (polling), bukan ditunggu terus-menerus.
Tidak ada progres yang terlihat
Request-response biasa tidak punya cara menunjukkan “sedang tahap 2 dari 5” — pengguna hanya melihat loading tanpa informasi apa pun sampai selesai atau timeout.
Pola Queue-Worker: Submit, Proses, Cek Status
import asyncio, enum, uuid, time

class StatusJob(str, enum.Enum):
    ANTRE = "antre"
    BERJALAN = "berjalan"
    SELESAI = "selesai"
    GAGAL = "gagal"

class Job:
    def __init__(self, tugas):
        self.id = uuid.uuid4().hex[:8]
        self.tugas = tugas
        self.status = StatusJob.ANTRE
        self.hasil = None
        self.error = None

class AntrianJob:
    def __init__(self, jumlah_worker=2):
        self.antrian = asyncio.Queue()
        self.job_map = {}
        self.jumlah_worker = jumlah_worker
        self._worker_tasks = []

    def submit(self, tugas) -> str:
        job = Job(tugas)
        self.job_map[job.id] = job
        self.antrian.put_nowait(job)
        return job.id

    def status_job(self, job_id):
        job = self.job_map.get(job_id)
        return None if job is None else {
            "id": job.id, "status": job.status.value,
            "hasil": job.hasil, "error": job.error,
        }

    async def _worker(self, nama_worker):
        while True:
            job = await self.antrian.get()
            job.status = StatusJob.BERJALAN
            try:
                job.hasil = await job.tugas()
                job.status = StatusJob.SELESAI
            except Exception as e:
                job.error = str(e)
                job.status = StatusJob.GAGAL
            finally:
                self.antrian.task_done()

    def mulai_worker(self):
        for i in range(self.jumlah_worker):
            self._worker_tasks.append(asyncio.create_task(self._worker(f"worker-{i}")))
Endpoint FastAPI di atasnya cukup sederhana: POST /proses-dokumen memanggil antrian.submit(tugas) dan langsung mengembalikan {"job_id": "..."}, sementara GET /status/{job_id} memanggil status_job() untuk polling dari sisi klien.
Empat Hal yang Diuji dan Terbukti Benar
1. Submit benar-benar instan. Diuji dengan tugas yang sengaja lambat (0,2 detik) — waktu yang dibutuhkan
submit() untuk kembali kurang dari 0,05 detik. Ini membuktikan endpoint tidak menunggu tugas selesai sama sekali, hanya mendaftarkannya ke antrian.
2. Worker memproses dan meng-update status dengan benar. Diuji end-to-end: job disubmit, worker dijalankan, ditunggu sampai antrian kosong (
antrian.join()) — status berubah dari antre ke selesai dengan hasil yang benar tersimpan.
3. Satu job gagal tidak menghentikan worker. Ini yang paling penting untuk diuji secara eksplisit: job yang melempar exception ditandai
gagal dengan pesan error tersimpan, TAPI job berikutnya di antrian tetap diproses sampai selesai. Tanpa blok try/except di dalam loop worker, satu job yang error akan mematikan seluruh worker — dan semua job setelahnya di antrian tidak pernah diproses tanpa ada yang tahu kenapa.
4. Worker paralel benar-benar mempercepat. Diuji dengan 4 tugas @ 0,1 detik dan 2 worker — total waktu sekitar 0,2 detik (dua job diproses bersamaan), bukan 0,4 detik seperti kalau diproses satu per satu. Jumlah worker menentukan seberapa banyak tugas yang benar-benar berjalan bersamaan, bukan sekadar antre berurutan.
Alur Kerja dari Sisi Klien
- Klien mengirim
POST /proses-dokumen, langsung menerima{"job_id": "a1b2c3d4"}dalam hitungan milidetik. - Klien melakukan polling ke
GET /status/a1b2c3d4setiap beberapa detik untuk mengecek status. - Selama status
antreatauberjalan, UI bisa menampilkan progres tanpa menahan koneksi tunggal yang lama. - Begitu status jadi
selesaiataugagal, klien mengambil hasil (atau pesan error) dan berhenti polling.
Batasan In-Memory Queue — dan Kapan Perlu yang Lebih Serius
Batasan yang perlu disadari: pola di atas menyimpan job di memori proses Python. Kalau proses restart (deploy baru, crash, auto-scaling menambah/mengurangi instance), semua job yang sedang antre atau berjalan hilang begitu saja — tidak ada mekanisme pemulihan. Untuk prototipe atau aplikasi dengan trafik rendah yang bisa menerima risiko ini, pola in-memory cukup. Untuk aplikasi production yang job-nya harus tetap ada meski proses restart, dibutuhkan queue yang persisten (disimpan di luar memori proses) seperti Redis dengan Celery atau RQ.
| Kebutuhan | In-memory (contoh di atas) | Redis + Celery/RQ |
|---|---|---|
| Job bertahan setelah restart proses | Tidak | Ya |
| Job dibagi ke banyak instance/mesin | Tidak — hanya dalam satu proses | Ya |
| Kompleksitas setup | Sangat rendah, tanpa dependency tambahan | Butuh Redis/broker terpisah |
| Cocok untuk | Prototipe, trafik rendah, single instance | Production dengan trafik signifikan |
Pertanyaan yang Sering Muncul
Kenapa tidak pakai BackgroundTasks FastAPI saja untuk semua kasus?
BackgroundTasks tidak memberi ID job atau cara mengecek status/progres dari luar — cocok untuk tugas “kirim lalu lupakan” seperti logging, tapi tidak untuk tugas yang hasilnya perlu diambil klien nanti. Job queue dengan status memberi visibilitas yang BackgroundTasks tidak punya secara bawaan.
Berapa jumlah worker yang ideal?
Tergantung sifat tugasnya. Untuk tugas yang didominasi menunggu jaringan (memanggil API model), jumlah worker bisa lebih banyak dari jumlah CPU core karena sebagian besar waktu dihabiskan menunggu, bukan menghitung. Untuk tugas yang berat secara komputasi lokal, jumlah worker yang terlalu banyak justru saling berebut CPU.
Bagaimana kalau pengguna perlu diberi tahu tanpa polling terus-menerus?
WebSocket atau server-sent events bisa menggantikan polling untuk push notifikasi saat status berubah, tapi menambah kompleksitas koneksi yang harus dikelola. Untuk kebanyakan kasus, polling setiap beberapa detik sudah cukup dan jauh lebih sederhana diimplementasikan dan di-debug.
Apakah job yang gagal bisa dicoba ulang otomatis?
Bisa ditambahkan sebagai lapisan tambahan — worker mengecek jumlah percobaan sebelum menandai job sebagai gagal permanen, dan mengembalikannya ke antrian kalau masih di bawah batas. Pola ini serupa dengan retry-backoff yang dibahas di artikel skill backend untuk AI engineering, hanya diterapkan di level job, bukan di level satu panggilan API.
Baca Juga:
Kesimpulan
Job queue memisahkan “menerima tugas” dari “mengerjakan tugas” — pemisahan yang jadi penting begitu tugas AI Anda cukup lama untuk menabrak timeout HTTP atau butuh ditampilkan progresnya. Pengujian di atas menunjukkan bagian yang paling sering luput: tanpa penanganan error yang benar di dalam loop worker, satu job yang gagal bisa mematikan seluruh worker dan menghentikan semua job setelahnya tanpa peringatan. Pola in-memory di artikel ini cukup untuk memulai, tapi begitu aplikasi butuh job yang tetap ada meski proses restart atau berjalan di banyak instance, saatnya beralih ke queue yang persisten seperti Redis.
Artikel terkait: skill backend untuk AI engineering.
Belum baca pola BackgroundTasks dan endpoint async lainnya?
Lihat pola FastAPI lengkap untuk aplikasi AI, dari validasi input sampai streaming.
Baca Selengkapnya