Daftar Isi:
- Kenapa FastAPI Cocok untuk Lapisan API AI
- 1. Validasi Input Sebelum Menyentuh Model
- 2. Async Endpoint yang Tidak Saling Memblokir
- 3. Rate Limiting — dan Jebakan yang Mudah Lolos Review
- 4. Streaming Respons Token demi Token
- 5. Background Task untuk Logging Tanpa Menahan Respons
- Menyusun Semuanya: Struktur Endpoint AI yang Wajar
- Tabel Ringkas: Fitur FastAPI dan Kapan Dipakai
- Pertanyaan yang Sering Muncul
- Kesimpulan
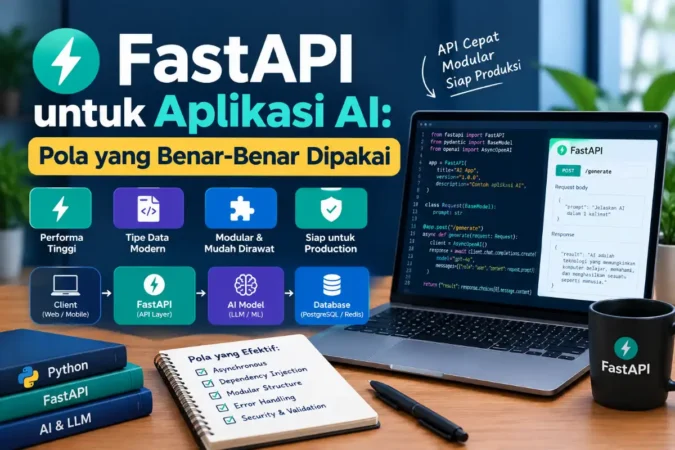
FastAPI untuk Aplikasi AI: Pola yang Benar-Benar Dipakai
Bukan sekadar “bikin endpoint POST” — ini tentang validasi input yang tidak bisa dipercaya, panggilan model yang lambat, dan trafik yang bisa menabrak rate limit vendor. FastAPI menyediakan alatnya; artikel ini menunjukkan cara memakainya dengan benar, termasuk satu jebakan yang mudah lolos dari review kode.
Kalau Anda backend developer yang mulai membangun fitur AI, kemungkinan besar Anda sudah tahu FastAPI: cepat, berbasis type hint, dan otomatis membuatkan dokumentasi OpenAPI. Yang sering tidak dibahas adalah bagaimana pola-pola khas FastAPI berubah ketika endpoint itu memanggil LLM — permintaan yang lambat, tidak murah, dan hasilnya tidak selalu terstruktur rapi seperti response API biasa.
Artikel ini membahas lima hal yang paling sering dibutuhkan saat FastAPI dipakai sebagai lapisan API di atas panggilan model: validasi input dengan Pydantic, endpoint async yang tidak memblokir, pembatasan laju permintaan, respons streaming, dan tugas latar belakang untuk logging. Semua contoh kode di bawah sudah diuji jalan dengan pytest sebelum ditulis di sini.
Kenapa FastAPI Cocok untuk Lapisan API AI
Validasi bawaan
Pydantic memvalidasi body request sebelum kode Anda sempat memanggil model — mencegah teks kosong atau field yang salah tipe sampai ke LLM yang mahal.
Native async
Panggilan ke API model biasanya I/O-bound (menunggu jaringan). FastAPI mendukung async def secara langsung, jadi satu proses bisa melayani banyak permintaan yang sedang menunggu model tanpa saling memblokir.
Streaming siap pakai
StreamingResponse memudahkan meneruskan token demi token dari model ke klien, bukan menunggu seluruh jawaban selesai baru dikirim.
Dokumentasi otomatis
Skema Pydantic yang sama untuk validasi juga menghasilkan dokumentasi OpenAPI — berguna kalau tim frontend atau tim lain perlu tahu bentuk request/response endpoint AI Anda.
1. Validasi Input Sebelum Menyentuh Model
Panggilan ke LLM API punya biaya per token dan latensi yang tidak kecil. Aturan pertama: jangan biarkan request yang jelas tidak valid — teks kosong, field yang salah tipe, teks yang kepanjangan — lolos sampai ke pemanggilan model. Pydantic menangani ini di lapisan endpoint, sebelum baris kode Anda yang lain dieksekusi.
from typing import Literal
from pydantic import BaseModel, Field

class PermintaanRingkasan(BaseModel):
    teks: str = Field(min_length=1, max_length=5000)
    gaya: Literal["singkat", "detail"] = "singkat"

class HasilRingkasan(BaseModel):
    ringkasan: str
    jumlah_kata_asli: int
    id_permintaan: str

@app.post("/ringkas", response_model=HasilRingkasan)
async def ringkas(permintaan: PermintaanRingkasan):
    hasil = await panggil_model_ringkas(permintaan.teks, permintaan.gaya)
    return HasilRingkasan(
        ringkasan=hasil,
        jumlah_kata_asli=len(permintaan.teks.split()),
        id_permintaan=uuid.uuid4().hex[:8],
    )
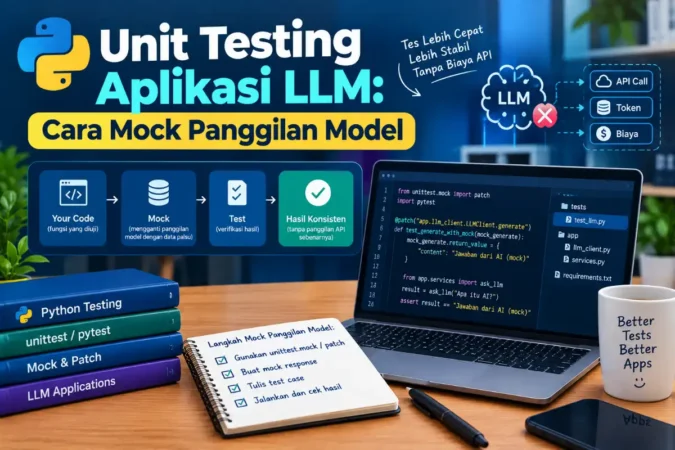
Diuji dengan httpx.AsyncClient dan ASGITransport (tanpa perlu menjalankan server sungguhan): request dengan teks kosong otomatis ditolak dengan status 422 sebelum masuk ke badan fungsi ringkas sama sekali — panggil_model_ringkas tidak pernah dipanggil. Itu berarti setiap validasi yang bisa dinyatakan lewat tipe Pydantic (panjang minimum, pilihan terbatas lewat Literal, format lewat Field) adalah token dan latensi yang tidak perlu dikeluarkan ke model.
2. Async Endpoint yang Tidak Saling Memblokir
Menulis async def pada endpoint tidak otomatis membuatnya cepat — itu hanya berarti endpoint boleh menyerahkan kontrol saat menunggu I/O. Kesalahan yang sering terjadi: memanggil SDK model yang sinkron (blocking) di dalam endpoint async, yang justru membekukan seluruh event loop, bukan cuma satu request.
Baca Juga:
Aturan praktis: kalau SDK client Anda punya versi async (kebanyakan SDK model modern punya, termasuk klien Gemini dan OpenAI), pakai versi itu di endpoint
async def. Kalau SDK-nya hanya sinkron, jalankan lewat run_in_threadpool dari Starlette atau asyncio.to_thread, jangan panggil langsung.
from starlette.concurrency import run_in_threadpool

@app.post("/ringkas-sdk-sinkron")
async def ringkas_sinkron(permintaan: PermintaanRingkasan):
    # sdk_sinkron.buat() adalah fungsi blocking biasa
    hasil = await run_in_threadpool(sdk_sinkron.buat, permintaan.teks)
    return {"ringkasan": hasil}
Dampaknya nyata di beban tinggi: satu endpoint yang salah memanggil fungsi blocking di dalam async def bisa membuat semua request lain — termasuk endpoint /health yang seharusnya instan — ikut menunggu, karena satu proses worker Uvicorn hanya punya satu event loop.
3. Rate Limiting — dan Jebakan yang Mudah Lolos Review
Sebagian besar API model punya batas permintaan per menit. Kalau aplikasi Anda punya banyak pengguna, membatasi laju di sisi aplikasi (bukan hanya menyerahkan error 429 dari vendor ke pengguna) membuat pengalaman lebih baik. Middleware adalah tempat wajar untuk logika ini karena berlaku ke semua endpoint sekaligus.
Temuan dari pengujian: melempar
HTTPException di dalam fungsi @app.middleware("http") tidak ditangkap oleh exception handler bawaan FastAPI. Saat diuji, ini membuat request berakhir sebagai 500 Internal Server Error tanpa pesan yang jelas ke klien — bukan status 429 yang dimaksud. Middleware HTTP di FastAPI berjalan di lapisan Starlette yang berbeda dari lapisan yang menangkap HTTPException pada endpoint biasa.
Perbaikannya: kembalikan objek Response secara langsung dari middleware, bukan melempar exception.
from fastapi.responses import JSONResponse

class PembatasLaju:
    def __init__(self, kapasitas=3, isi_ulang_per_detik=0.5):
        self.kapasitas = kapasitas
        self.isi_ulang = isi_ulang_per_detik
        self.saldo, self.waktu_terakhir = {}, {}

    def izinkan(self, klien):
        sekarang = time.monotonic()
        saldo = self.saldo.get(klien, self.kapasitas)
        terakhir = self.waktu_terakhir.get(klien, sekarang)
        saldo = min(self.kapasitas, saldo + (sekarang - terakhir) * self.isi_ulang)
        if saldo < 1:
            self.saldo[klien], self.waktu_terakhir[klien] = saldo, sekarang
            return False
        self.saldo[klien], self.waktu_terakhir[klien] = saldo - 1, sekarang
        return True

pembatas = PembatasLaju()

@app.middleware("http")
async def batasi_laju(request: Request, call_next):
    klien = request.client.host if request.client else "unknown"
    if not pembatas.izinkan(klien):
        # Kembalikan Response langsung — JANGAN raise HTTPException di sini.
        return JSONResponse(status_code=429, content={"detail": "Terlalu banyak permintaan"})
    return await call_next(request)
Diuji dengan mengirim 6 permintaan beruntun dengan kapasitas token bucket 3: permintaan ke-4 dan seterusnya konsisten mendapat status 429 dengan body JSON yang benar, sementara versi yang melempar HTTPException gagal dengan 500 pada uji yang sama. Pola token bucket ini juga lebih adil dibanding pembatas laju berbasis jendela tetap (fixed window), karena tidak ada lonjakan permintaan di batas pergantian menit.
4. Streaming Respons Token demi Token
Untuk endpoint chat atau generate teks panjang, menunggu seluruh jawaban model selesai sebelum mengirim respons membuat pengguna menatap layar kosong. StreamingResponse meneruskan output begitu tersedia.
from fastapi.responses import StreamingResponse

@app.post("/ringkas-stream")
async def ringkas_stream(permintaan: PermintaanRingkasan):
    async def pembangkit():
        async for potongan in model_stream(permintaan.teks):
            yield potongan
    return StreamingResponse(pembangkit(), media_type="text/plain")
Diuji dengan generator async sederhana yang menghasilkan potongan teks dengan jeda kecil di antaranya, lalu dikonsumsi lewat client.stream() dari httpx — potongan diterima satu per satu, bukan sebagai satu blok di akhir, mengonfirmasi bahwa response benar-benar mengalir dan tidak dibuffer penuh oleh FastAPI sebelum dikirim.
5. Background Task untuk Logging Tanpa Menahan Respons
Mencatat setiap permintaan (untuk audit token, biaya, atau debugging) sering melibatkan I/O — tulis ke database atau file log — yang tidak perlu ditunggu pengguna. BackgroundTasks milik FastAPI menjadwalkan fungsi itu berjalan setelah badan respons selesai dibentuk.
from fastapi import BackgroundTasks

def catat_log(pesan: str):
    # tulis ke DB/file di sini — boleh agak lambat
    ...

@app.post("/proses")
async def proses(masukan: Masukan, background_tasks: BackgroundTasks):
    background_tasks.add_task(catat_log, f"diproses: {masukan.teks}")
    return {"status": "diterima"}
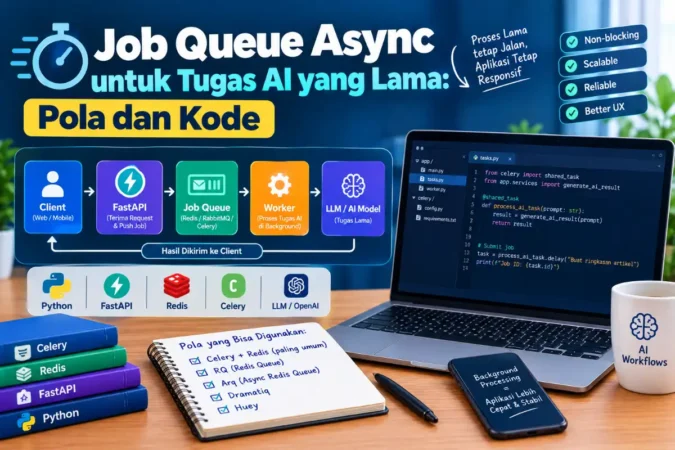
Diuji dengan mencatat urutan eksekusi ke sebuah list: respons selalu terbentuk lebih dulu, baru fungsi logging berjalan sesudahnya — sesuai urutan yang diharapkan. Catatan jujur dari pengujian ini: pada test client in-process (ASGITransport), waktu tunggu keseluruhan tetap mencakup durasi background task karena tidak ada koneksi jaringan sungguhan yang terputus lebih awal. Di deployment nyata dengan server ASGI seperti Uvicorn, klien tetap menerima byte respons tanpa menunggu task tambahan itu, tapi ini bukan pengganti message queue kalau task-nya berat atau harus tahan terhadap restart proses — untuk itu pakai antrian sungguhan seperti Celery atau RQ.
Menyusun Semuanya: Struktur Endpoint AI yang Wajar
- Definisikan skema Pydantic untuk request dan response — batasi panjang teks dan pilihan yang valid selengkap mungkin di sini.
- Gunakan
async defdan panggil SDK model versi async; kalau SDK hanya sinkron, bungkus denganrun_in_threadpool. - Tangani error dari model (timeout, rate limit vendor) dengan
try/exceptdi dalam endpoint, ubah jadiHTTPExceptionyang jelas — bukan biarkan lolos sebagai 500 generik. - Tambahkan pembatas laju di middleware kalau aplikasi menerima trafik dari banyak pengguna — ingat, kembalikan
Response, janganraise. - Pertimbangkan
StreamingResponseuntuk jawaban panjang, danBackgroundTasksuntuk logging atau pencatatan biaya token yang tidak perlu menahan pengguna.
Tabel Ringkas: Fitur FastAPI dan Kapan Dipakai
| Fitur | Dipakai untuk | Hal yang perlu diwaspadai |
|---|---|---|
Pydantic BaseModel | Validasi request/response endpoint AI | Batasi panjang teks — jangan andalkan model untuk menolak input aneh |
async def + SDK async | Memanggil model tanpa memblokir worker | SDK sinkron yang dipanggil langsung membekukan seluruh proses |
Middleware http | Rate limiting, logging request masuk | HTTPException di sini tidak ditangkap — kembalikan Response |
StreamingResponse | Jawaban panjang, chat token demi token | Klien (proxy, load balancer) harus mendukung streaming juga |
BackgroundTasks | Logging ringan, notifikasi setelah respons | Bukan pengganti antrian pesan untuk tugas berat/kritis |
Pertanyaan yang Sering Muncul
Apakah FastAPI wajib dipakai untuk aplikasi AI?
Tidak wajib — Flask atau framework lain juga bisa membungkus panggilan LLM. FastAPI unggul karena validasi tipe bawaan dan dukungan async yang alami, dua hal yang langsung relevan begitu endpoint memanggil model eksternal yang lambat.
Kenapa endpoint saya tetap lambat padahal sudah pakai async def?
Periksa apakah ada pemanggilan fungsi sinkron (SDK model, query database sinkron, operasi file blocking) di dalam fungsi async itu. Satu pemanggilan blocking saja bisa membekukan seluruh event loop, bukan cuma request yang bersangkutan — lihat bagian async endpoint di atas.
Baca Juga:
Perlu Redis untuk rate limiting, atau cukup di memori?
Token bucket di memori seperti contoh di atas cukup untuk satu proses/instance. Begitu aplikasi berjalan di lebih dari satu instance (horizontal scaling), batas laju per-instance tidak lagi mencerminkan batas per-pengguna secara keseluruhan, dan menyimpan status penghitung di Redis (atau layanan sejenis) jadi diperlukan.
StreamingResponse cocok untuk semua jenis endpoint AI?
Cocok untuk jawaban yang dibaca manusia secara bertahap, seperti chat. Untuk endpoint yang hasilnya harus divalidasi utuh sebagai satu objek terstruktur (lihat structured output LLM), streaming per-token justru menyulitkan karena JSON yang belum lengkap tidak bisa divalidasi di tengah jalan.
Kesimpulan
FastAPI tidak membuat aplikasi AI otomatis andal — tapi menyediakan tempat yang tepat untuk menaruh setiap lapisan pertahanan yang dibutuhkan: validasi input lewat Pydantic sebelum token dan uang dikeluarkan ke model, penanganan async yang benar supaya satu permintaan lambat tidak membekukan yang lain, dan pembatas laju yang harus ditulis dengan cara yang benar-benar tertangkap oleh FastAPI, bukan lewat raise yang terlihat wajar tapi diam-diam berakhir sebagai 500. Kalau Anda datang dari latar belakang backend, pola-pola ini bukan hal baru — yang baru hanyalah menyadari di titik mana panggilan ke model butuh perlakuan berbeda dari endpoint CRUD biasa.
Artikel terkait: skill backend untuk AI engineering, Python untuk AI engineer, dan cara menggunakan Gemini API dengan Python.
Mau baca peta jalan lengkapnya dari nol?
Lihat roadmap AI engineering dari sudut pandang backend developer.
Baca Roadmap