Daftar Isi:
Caching LLM: Exact Cache vs Semantic Cache, Mana Dipakai
Panggilan ke LLM tidak murah dan tidak instan — kalau pertanyaan yang sama (atau semirip) datang berulang, menjawabnya lagi dari model adalah token yang terbuang. Ada dua cara menyimpan jawaban lama, dan salah satunya bisa diam-diam mengembalikan jawaban yang salah. Berikut buktinya, dari kode yang benar-benar dijalankan.
Kalau aplikasi Anda punya fitur tanya-jawab, ringkasan, atau klasifikasi berbasis LLM, kemungkinan besar sebagian pertanyaan yang masuk berulang — baik persis sama maupun beda kata tapi maksudnya sama. Memanggil model lagi untuk pertanyaan yang jawabannya sudah pernah dihitung adalah biaya token dan latensi yang sebenarnya bisa dihindari. Ada dua pendekatan caching yang biasa dipakai, dan keduanya punya trade-off yang berbeda drastis.
Exact Cache: Cocok Kalau Kunci-nya Memang Sama Persis
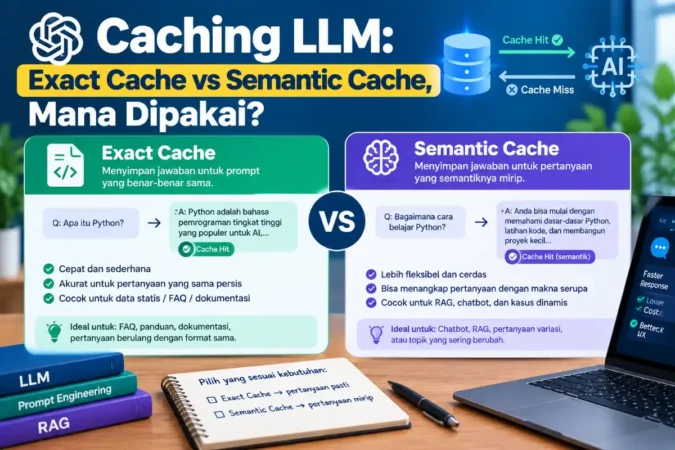
Exact cache menyimpan jawaban berdasarkan hash dari kombinasi model, instruksi, dan input. Kalau kombinasi persis itu datang lagi (setelah dinormalisasi — huruf besar/kecil, spasi di ujung), jawaban lama langsung dipakai tanpa memanggil model.
import hashlib, json, time

class CacheEksakTTL:
    def __init__(self, ttl_detik=3600):
        self.ttl = ttl_detik
        self.data = {}

    def kunci(self, model, instruksi, masukan):
        mentah = json.dumps([model, instruksi, masukan.strip().lower()], ensure_ascii=False)
        return hashlib.sha256(mentah.encode()).hexdigest()

    def ambil(self, k):
        entri = self.data.get(k)
        if entri is None:
            return None
        nilai, kadaluarsa = entri
        if time.time() > kadaluarsa:
            del self.data[k]
            return None
        return nilai

    def simpan(self, k, nilai):
        self.data[k] = (nilai, time.time() + self.ttl)
Diuji dengan tiga panggilan: “Apa itu RAG?”, lalu “apa itu rag?” (beda kapitalisasi), lalu “Apa itu embedding?”. Hasilnya sesuai harapan — panggilan pertama dan ketiga memanggil model (2 panggilan nyata), panggilan kedua cache-hit karena normalisasi huruf kecil menyamakan kuncinya meski kapitalisasi beda. Exact cache murah dihitung (hash biasa, bukan embedding) dan hasilnya deterministik: tidak pernah salah mengembalikan jawaban untuk pertanyaan yang berbeda, karena kecocokannya harus persis.
Semantic Cache: Menangkap Pertanyaan yang Beda Kata, Sama Makna
Masalah exact cache: pengguna jarang menulis pertanyaan dengan kata yang persis sama. “Berapa harga langganan bulanan” dan “biaya paket per bulan berapa” punya makna yang identik tapi hash-nya beda total — exact cache akan menganggapnya dua pertanyaan berbeda dan memanggil model dua kali. Semantic cache mengatasi ini dengan membandingkan embedding (representasi vektor makna) memakai cosine similarity, bukan mencocokkan teks.
import math

def kosinus(a, b):
    dot = sum(x*y for x, y in zip(a, b))
    na = math.sqrt(sum(x*x for x in a))
    nb = math.sqrt(sum(x*x for x in b))
    return dot / (na * nb) if na and nb else 0.0

class CacheSemantik:
    def __init__(self, ambang_mirip=0.95):
        self.ambang = ambang_mirip
        self.entri = []

    def cari(self, embedding_baru):
        terbaik, skor_terbaik = None, 0.0
        for emb, pertanyaan, jawaban in self.entri:
            skor = kosinus(embedding_baru, emb)
            if skor > skor_terbaik:
                skor_terbaik, terbaik = skor, (pertanyaan, jawaban)
        if terbaik and skor_terbaik >= self.ambang:
            return terbaik[1], skor_terbaik
        return None, skor_terbaik

    def simpan(self, embedding, pertanyaan, jawaban):
        self.entri.append((embedding, pertanyaan, jawaban))
Diuji dengan embedding simulasi: pertanyaan “biaya paket per bulan berapa” dibandingkan dengan cache berisi “berapa harga langganan bulanan” (makna sama, kata beda) — skor kemiripan 0,993, di atas ambang 0,95, cache-hit dengan jawaban yang benar. Pertanyaan yang topiknya benar-benar beda (“cara reset password akun saya”) menghasilkan skor hanya 0,171 — jauh di bawah ambang, sehingga tidak salah cache-hit. Sejauh ini terlihat lebih pintar dari exact cache.
Risiko Nyata: False Positive yang Terbukti dari Pengujian
Ditemukan lewat pengujian: dua pertanyaan dengan struktur kalimat sangat mirip tapi merujuk entitas berbeda — “harga paket premium berapa” dan “harga paket basic berapa” — menghasilkan skor kemiripan embedding 1,000, di atas ambang berapa pun yang masuk akal. Semantic cache mengembalikan jawaban harga paket Premium untuk pertanyaan tentang paket Basic. Ini bukan bug di kode cache-nya — ini keterbatasan mendasar dari mengandalkan kemiripan makna kalimat untuk keputusan yang sebenarnya butuh kecocokan entitas persis.
Ini masalah yang nyata, bukan kasus tepi yang jarang terjadi: nama produk, nomor pesanan, tanggal, dan angka spesifik sering kali punya pengaruh kecil terhadap embedding kalimat dibanding struktur dan topik kalimatnya secara keseluruhan. Dua kalimat yang “hampir sama” secara semantik bisa punya jawaban yang harus benar-benar berbeda.
Kapan Pakai yang Mana
| Situasi | Cache yang lebih cocok | Alasan |
|---|---|---|
| FAQ statis, prompt template dengan variabel tetap | Exact cache | Pertanyaan memang datang dalam bentuk yang konsisten |
| Chat bebas dari pengguna, pertanyaan bervariasi | Semantic cache (dengan hati-hati) | Variasi kata tinggi, exact cache jarang hit |
| Jawaban menyebut angka/entitas spesifik (harga per produk, status pesanan) | Exact cache, atau semantic + verifikasi entitas | False positive semantic cache bisa memberi jawaban salah yang meyakinkan |
| Klasifikasi/ekstraksi terstruktur | Exact cache | Input yang sama harus selalu menghasilkan output yang sama; semantic cache menambah variabilitas yang tidak perlu |
Untuk kasus di mana semantic cache tetap diperlukan (chat bebas dengan variasi kata tinggi), mitigasi yang masuk akal: naikkan ambang kemiripan jauh di atas 0,95, ekstrak entitas kunci (nama produk, angka, tanggal) dari pertanyaan terlebih dahulu dan wajibkan kecocokan persis pada entitas itu sebelum menerima cache-hit dari kemiripan embedding, dan hindari semantic cache sama sekali untuk endpoint yang jawabannya menyebut data spesifik per-pengguna atau per-produk.
Pertanyaan yang Sering Muncul
Apakah semantic cache berarti tidak perlu exact cache lagi?
Tidak — keduanya sering dipakai berlapis. Cek exact cache dulu (murah, tidak butuh panggilan embedding), baru kalau tidak ada yang cocok, cek semantic cache. Ini menghemat biaya menghitung embedding untuk kasus yang sebenarnya sudah bisa dijawab dari exact match.
Berapa ambang kemiripan yang aman untuk semantic cache?
Tidak ada angka universal — tergantung seberapa besar konsekuensi jawaban yang salah. Dari pengujian di atas, ambang 0,95 pun masih bisa kebobolan kasus “premium vs basic” yang skornya 1,000. Untuk konten yang salahnya berisiko tinggi, verifikasi entitas kunci di luar skor kemiripan jauh lebih aman daripada menaikkan ambang saja.
Baca Juga:
Apakah caching mengurangi kualitas jawaban karena jawabannya jadi “basi”?
TTL (time-to-live) mengatasi ini sebagian — jawaban dianggap kedaluwarsa setelah durasi tertentu. Tapi untuk informasi yang berubah cepat (harga, stok, status), TTL pendek atau tidak menyimpan cache sama sekali lebih aman daripada mengandalkan TTL panjang demi hemat biaya.
Di mana cache ini sebaiknya disimpan — memori proses atau Redis?
Cache di memori proses (seperti contoh di atas) cukup untuk satu instance. Begitu aplikasi berjalan di banyak instance, cache di memori tidak dibagi antar instance, sehingga sebagian permintaan tetap memanggil model meski instance lain baru saja menghitung jawaban yang sama — Redis atau penyimpanan bersama sejenis diperlukan untuk cache yang efektif lintas instance.
Kesimpulan
Exact cache aman tapi kaku — hanya menangkap pertanyaan yang benar-benar identik. Semantic cache lebih fleksibel tapi punya risiko yang terbukti nyata dari pengujian di atas: dua pertanyaan yang terdengar mirip bisa punya skor kemiripan sempurna padahal jawabannya harus berbeda total. Keputusan mana yang dipakai bukan soal mana yang “lebih canggih” — soal seberapa besar akibatnya kalau cache salah mengembalikan jawaban, dan untuk kasus itu, exact cache yang membosankan sering kali pilihan yang lebih aman.
Artikel terkait: skill backend untuk AI engineering dan RAG adalah.
Mau tahu cara menghitung biaya token yang dihemat dari caching?
Baca cara menghitung biaya token LLM API dalam rupiah, lengkap dengan contoh perhitungan.
Baca Selengkapnya