Daftar Isi:
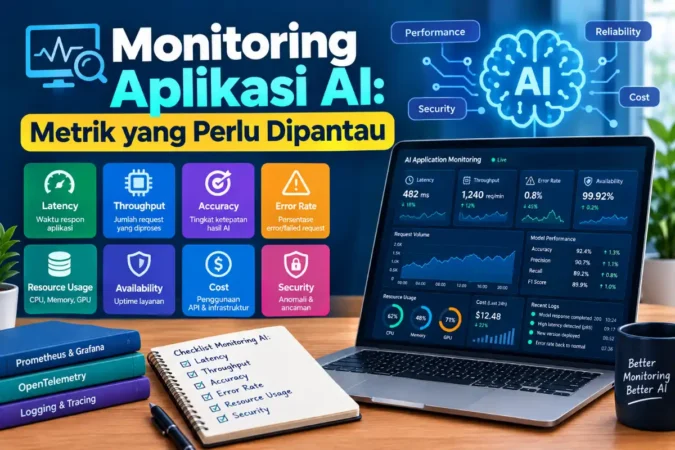
Monitoring Aplikasi AI: Metrik yang Perlu Dipantau
Endpoint yang memanggil LLM bisa “hidup” — merespons 200 OK — sambil diam-diam gagal memenuhi kebutuhan penggunanya: lambat, sering timeout ke vendor, atau jawabannya makin sering tidak valid. Log biasa tidak cukup untuk menangkap ini. Ini pola logging dan metrik yang cukup untuk tahu aplikasi AI Anda benar-benar sehat, lengkap dengan kode yang sudah diuji jalan.
Monitoring aplikasi backend biasa biasanya cukup dengan status code dan waktu respons. Aplikasi yang memanggil LLM punya beberapa cara gagal tambahan yang tidak muncul di monitoring standar: model merespons lambat tapi tetap 200 OK, rate limit dari vendor yang datang sporadis, atau token yang membengkak diam-diam karena riwayat percakapan yang terus bertambah. Kalau Anda sudah membaca artikel skill backend untuk AI engineering, bagian logging di sana baru menyentuh dasarnya — artikel ini masuk lebih dalam ke metrik apa yang perlu dihitung dari log itu, dan kenapa rata-rata saja tidak cukup.
Kenapa Log Biasa Tidak Cukup
Latensi tersembunyi di balik 200 OK
Model yang merespons dalam 8 detik tetap mengembalikan status sukses. Tanpa mencatat durasi per panggilan, lambatnya baru ketahuan dari keluhan pengguna, bukan dari dashboard.
Rata-rata menyembunyikan masalah nyata
Rata-rata latensi bisa terlihat wajar padahal 5% permintaan butuh waktu 10x lipat. Persentil (p95, p99) menunjukkan pengalaman pengguna yang paling buruk, bukan yang biasa-biasa saja.
Error dari vendor beda jenis dari bug sendiri
Timeout, rate limit 429 dari vendor, dan bug validasi di kode sendiri butuh respons berbeda. Mencampur semuanya jadi satu angka “error rate” membuat sulit tahu apa yang harus diperbaiki lebih dulu.
1. Logging Terstruktur per Panggilan Model
Dasar dari semua metrik yang berguna adalah satu baris log JSON per panggilan model, berisi durasi, status, dan konteks yang cukup untuk dikelompokkan nanti.
import json, logging, time, uuid
from contextlib import contextmanager

log = logging.getLogger("ai_app")

@contextmanager
def lacak_panggilan_model(model: str, **konteks):
    id_panggilan = uuid.uuid4().hex[:8]
    mulai = time.perf_counter()
    hasil = {"status": "ok"}
    try:
        yield hasil
    except Exception as e:
        hasil["status"] = "error"
        hasil["jenis_error"] = type(e).__name__
        raise
    finally:
        durasi_ms = round((time.perf_counter() - mulai) * 1000, 1)
        catatan = {
            "id_panggilan": id_panggilan, "model": model,
            "durasi_ms": durasi_ms, **hasil, **konteks,
        }
        log.info(json.dumps(catatan, ensure_ascii=False))

# Pemakaian:
with lacak_panggilan_model("gemini-3.8-flash", fitur="ringkasan") as hasil:
    respons = panggil_model(teks)
    hasil["token_masuk"] = respons.token_masuk
    hasil["token_keluar"] = respons.token_keluar
Diuji dengan tiga skenario: panggilan sukses, TimeoutError, dan ConnectionError (mensimulasikan rate limit vendor). Ketiganya menghasilkan satu baris JSON yang konsisten — durasi tercatat, status benar (ok/error), dan jenis error tersimpan terpisah untuk yang gagal. Karena polanya contextmanager, exception yang terjadi di dalam blok tetap dilempar ulang ke pemanggil setelah dicatat — logging tidak menelan error yang seharusnya ditangani lapisan lain.
2. Menghitung Metrik yang Benar-Benar Berguna
Dari kumpulan log seperti di atas, tiga angka yang paling sering menjawab pertanyaan “apakah aplikasi AI saya sehat”: tingkat error, latensi p50 (median), dan latensi p95.
import statistics

def ringkas_metrik(catatan_list):
    total = len(catatan_list)
    gagal = [c for c in catatan_list if c["status"] == "error"]
    durasi = sorted(c["durasi_ms"] for c in catatan_list)
    p95_index = min(int(len(durasi) * 0.95), len(durasi) - 1)
    return {
        "total_panggilan": total,
        "tingkat_error": round(len(gagal) / total * 100, 1),
        "durasi_p50_ms": round(statistics.median(durasi), 1),
        "durasi_p95_ms": durasi[p95_index],
        "rincian_error": {
            jenis: sum(1 for c in gagal if c.get("jenis_error") == jenis)
            for jenis in set(c.get("jenis_error") for c in gagal)
        },
    }
Diuji dengan data simulasi 24 panggilan (20 sukses dengan durasi wajar sekitar 200ms, 1 sukses yang lambat di 3200ms, 3 timeout, dan 1 rate limit) — hasilnya menunjukkan pola nyata yang sering terlewat kalau hanya melihat rata-rata:
210msMedian (p50)
5000msp95 latensi
16,7%Tingkat error
Median 210ms terlihat sehat — kebanyakan permintaan memang cepat. Tapi p95 di 5000ms mengungkap bahwa 1 dari 20 permintaan mengalami masalah serius (baik karena lambat sungguhan atau tergolong error yang durasinya ikut dihitung). Kalau tim hanya memantau rata-rata, masalah ini bisa tersembunyi selama berminggu-minggu sampai cukup banyak pengguna mengeluh.
Baca Juga:
3. Ambang Batas untuk Alert — Bukan Sekadar Angka
Kesalahan umum: memasang alert hanya berdasarkan status HTTP 5xx. Aplikasi AI bisa punya masalah serius (latensi tinggi, rate limit vendor berulang) sambil tetap mengembalikan 200 OK ke pengguna karena ada fallback atau retry yang “berhasil” tapi lambat.
def perlu_alert(metrik, batas_error_persen=5, batas_p95_ms=3000):
    alasan = []
    if metrik["tingkat_error"] > batas_error_persen:
        alasan.append(f"tingkat error {metrik['tingkat_error']}% > batas {batas_error_persen}%")
    if metrik["durasi_p95_ms"] > batas_p95_ms:
        alasan.append(f"p95 latensi {metrik['durasi_p95_ms']}ms > batas {batas_p95_ms}ms")
    return alasan
Dijalankan dengan hasil metrik dari contoh di atas, fungsi ini benar mengembalikan dua alasan sekaligus: tingkat error 16,7% melampaui batas 5%, dan p95 latensi 5000ms melampaui batas 3000ms. Bandingkan dengan rincian_error yang memisahkan TimeoutError dari ConnectionError — pemisahan ini penting karena tindak lanjutnya berbeda: timeout berulang biasanya berarti perlu menaikkan batas waktu atau mengecek beban model, sementara error koneksi berulang biasanya berarti perlu menerapkan retry dengan backoff yang lebih agresif.
Tiga Lapis Observability: Log, Metrik, Trace
| Lapisan | Menjawab pertanyaan | Contoh di aplikasi AI |
|---|---|---|
| Log | Apa yang terjadi pada satu permintaan spesifik? | Baris JSON per panggilan model dengan id_panggilan untuk ditelusuri |
| Metrik | Bagaimana kesehatan sistem secara keseluruhan? | Tingkat error, p50/p95 latensi, agregat per jam |
| Trace | Di tahap mana waktu paling banyak terpakai? | Retrieval RAG vs panggilan model vs validasi output, per permintaan |
Untuk aplikasi kecil sampai menengah, log terstruktur plus metrik agregat seperti di atas biasanya cukup. Trace terdistribusi (melacak satu permintaan lintas beberapa layanan) baru jadi penting ketika alur permintaan melewati banyak service terpisah — misalnya layanan retrieval RAG, layanan pemanggil model, dan layanan validasi output berjalan sebagai proses berbeda.
Pertanyaan yang Sering Muncul
Apakah perlu tools monitoring khusus AI, atau cukup tools APM biasa?
Tools APM (application performance monitoring) umum tetap bisa dipakai selama Anda mengirim metrik kustom ke sana — durasi panggilan model, token, jenis error. Yang membedakan aplikasi AI bukan alatnya, tapi metrik tambahan yang perlu dicatat: token, biaya, dan skor validitas output, yang tidak otomatis ditangkap oleh APM generik.
Berapa lama data log sebaiknya disimpan?
Tergantung kebutuhan audit dan volume trafik — tidak ada angka universal. Yang lebih penting dari durasi penyimpanan adalah memisahkan log detail (untuk debugging kasus per kasus) dari metrik agregat (untuk tren jangka panjang), karena volume log mentah biasanya jauh lebih besar dan tidak semuanya perlu disimpan selama itu.
Kenapa p95 dipilih, bukan p99 atau rata-rata?
p95 adalah titik tengah yang umum dipakai — cukup ketat untuk menangkap masalah pada sebagian kecil permintaan, tapi tidak terlalu sensitif terhadap satu-dua outlier ekstrem seperti p99. Untuk aplikasi dengan trafik besar dan SLA ketat, memantau p95 dan p99 sekaligus lebih informatif daripada memilih salah satu.
Apakah mencatat token dan biaya termasuk bagian dari monitoring ini?
Ya, dan itu dibahas lebih detail di artikel tentang biaya token LLM API — pola pencatatannya bisa digabung ke context manager yang sama seperti contoh di atas, cukup menambahkan field token ke dalam hasil.
Kesimpulan
Monitoring aplikasi AI bukan soal memasang tools yang lebih canggih — soal mencatat hal yang tepat sejak awal. Satu context manager yang mencatat durasi, status, dan jenis error setiap panggilan model sudah cukup untuk menghitung metrik yang benar-benar menjawab “apakah aplikasi ini sehat”: tingkat error per jenis kegagalan, dan persentil latensi yang tidak tertutupi oleh rata-rata. Pengujian di atas menunjukkan kenapa ini penting — data yang median-nya terlihat sehat (210ms) bisa menyembunyikan p95 yang jauh lebih buruk (5000ms), dan itu perbedaan antara aplikasi yang terasa cepat bagi 95% pengguna dan yang lambat bagi 5% yang justru paling mungkin komplain.
Artikel terkait: skill backend untuk AI engineering dan biaya token LLM API.
Baru mau mulai deploy aplikasi AI ke production?
Baca dulu pola fail-fast, health check, dan graceful shutdown yang perlu ada sebelum monitoring ini terpasang.
Baca Panduan DeployBaca Juga: