Daftar Isi:
- Skill Backend untuk AI Engineering Adalah
- Peta 12 Skill: Masalah yang Dipecahkan
- Tiga Skill yang Kami Uji dengan Kode
- Skill Lain yang Sering Diremehkan
- Urutan Belajar Berdasarkan Kebutuhan
- Daftar Periksa: Seberapa Siap Backend Anda untuk Fitur AI?
- Kesalahan Umum
- FAQ
- Skill backend apa yang paling penting untuk AI engineer?
- Apakah harus jago backend sebelum belajar AI?
- Kenapa fitur AI butuh retry dan timeout?
- Apakah caching aman untuk jawaban AI?
- Bagaimana mengendalikan biaya API model?
- Apakah harus memakai antrean untuk semua fitur AI?
- Bahasa atau framework apa yang sebaiknya dipelajari?
- Kesimpulan
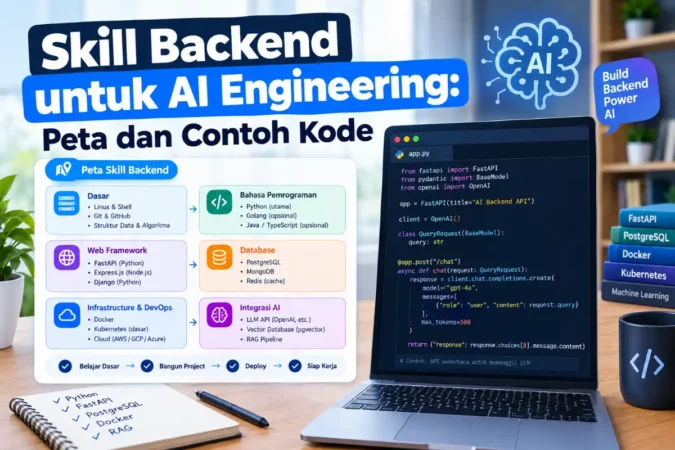
Ketika orang membicarakan skill AI engineer, yang muncul biasanya prompt, RAG, dan nama-nama model. Padahal ketika sebuah fitur AI gagal di produksi, penyebabnya jarang berupa prompt yang kurang bagus. Lebih sering: permintaan yang menggantung karena model lambat, tagihan yang melonjak karena percobaan ulang tanpa batas, data pengguna yang bocor karena filter akses tidak ada, atau tidak seorang pun tahu apa yang terjadi karena tidak ada log.
Semua itu adalah masalah backend. Artikel ini memetakan 12 skill backend ke masalah konkret yang muncul saat membangun fitur AI, lengkap dengan contoh kode yang kami uji, urutan belajar berdasarkan kebutuhan, dan daftar periksa untuk menilai kesiapan Anda sendiri.
Skill Backend untuk AI Engineering Adalah
Skill backend untuk AI engineering adalah kemampuan rekayasa sisi server yang membuat fitur berbasis model bahasa andal, aman, terukur, dan terjangkau saat dipakai pengguna nyata, bukan hanya berjalan sebagai demo.
Kuncinya ada pada sifat model sebagai layanan eksternal: ia lambat dibanding pemanggilan fungsi biasa, mahal per permintaan, tidak selalu memberi keluaran yang sama, dan bisa gagal kapan saja. Semua sifat itu adalah bahan klasik rekayasa backend, hanya dengan taruhan biaya yang lebih terasa. Urutan belajar lengkap dari nol ada di roadmap AI engineering dari backend. Artikel ini melengkapinya dari sisi sebaliknya: begitu Anda sudah paham fitur AI, skill backend mana yang menyelamatkan Anda di produksi.
Peta 12 Skill: Masalah yang Dipecahkan
| Skill backend | Masalah di fitur AI | Praktik yang dipakai |
|---|---|---|
| 1. Desain API dan streaming | Jawaban model lambat, pengguna menunggu dengan layar kosong | Kirim jawaban bertahap agar terlihat “mengetik”, tetapkan kontrak respons yang jelas |
| 2. Async dan konkurensi | Server macet karena banyak permintaan menunggu model | Pemanggilan non-blokir, batasi jumlah panggilan paralel |
| 3. Timeout, retry, backoff | Model atau jaringan gagal sesekali | Batas waktu tegas, percobaan ulang bertahap dengan jeda |
| 4. Idempotency dan deduplikasi | Klien mengirim ulang, biaya ganda | Kunci permintaan unik, seperti di idempotency payment API |
| 5. Caching | Pertanyaan sama berulang, biaya dan waktu terbuang | Simpan jawaban dengan kunci dari model, instruksi, dan masukan |
| 6. Rate limiting dan kuota | Satu pengguna menghabiskan anggaran atau batas penyedia | Batas per pengguna, anggaran harian, peringatan biaya (lihat biaya token LLM API) |
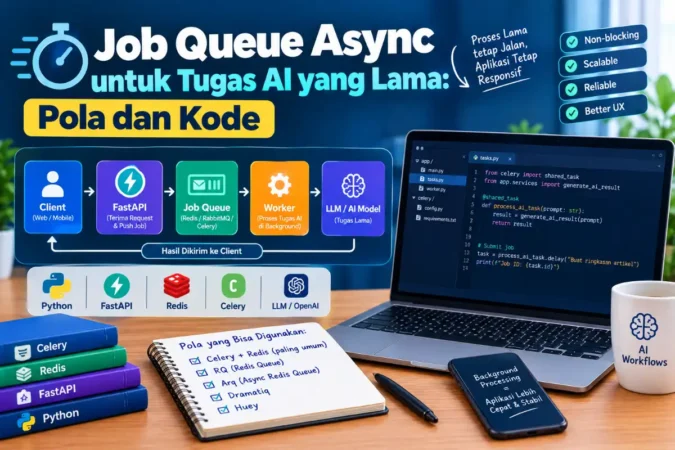
| 7. Antrean dan pekerjaan latar | Tugas panjang menahan permintaan HTTP | Masukkan ke antrean, kerjakan di latar, beri status |
| 8. Database dan SQL | Riwayat, metadata, dan vektor harus tersimpan rapi | Skema jelas, indeks, pencarian vektor (lihat pgvector untuk RAG) |
| 9. Autentikasi dan hak akses | Pengguna melihat dokumen yang bukan haknya | Filter akses di setiap query pencarian |
| 10. Observability | Sistem gagal dan tidak ada yang tahu sebabnya | Log terstruktur, metrik latensi, token, biaya, status |
| 11. Keamanan | Kunci API bocor, masukan berbahaya, data sensitif terkirim | Rahasia di variabel lingkungan, validasi masukan, tinjau data yang dikirim ke model |
| 12. Pengujian dan evaluasi | Perubahan prompt diam-diam merusak kualitas | Uji otomatis dan dataset evaluasi (lihat evaluasi LLM) |
Tiga Skill yang Kami Uji dengan Kode
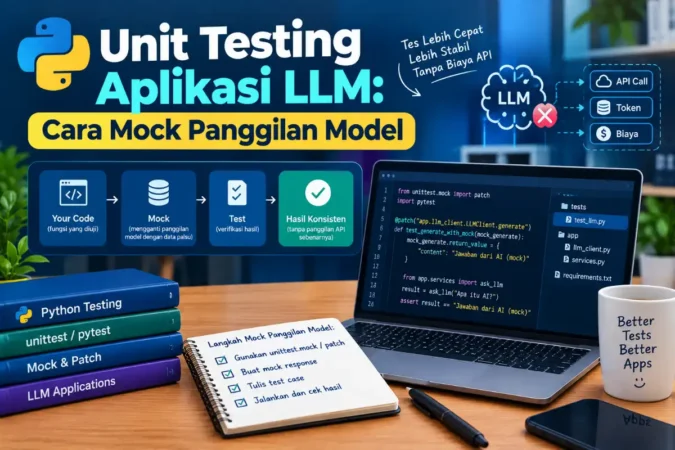
Cara kami menguji: semua contoh di bawah dijalankan di Python dengan fungsi model tiruan (yang sengaja gagal, lambat, atau berhasil), bukan dengan API sungguhan. Tujuannya memverifikasi perilaku logika backend-nya, bukan kualitas jawaban model.
Skill 3: Timeout dan Percobaan Ulang
Fungsi berikut membungkus panggilan model dengan batas waktu dan percobaan ulang bertahap. Jeda antarpercobaan membesar dua kali lipat ditambah sedikit acak supaya banyak klien tidak mencoba ulang serentak.
import asyncio, random

async def panggil_dengan_coba_ulang(fungsi, *, batas_waktu=10, maks_coba=3, jeda_awal=0.5):
    for percobaan in range(1, maks_coba + 1):
        try:
            return await asyncio.wait_for(fungsi(), timeout=batas_waktu)
        except (asyncio.TimeoutError, ConnectionError):
            if percobaan == maks_coba:
                raise
            jeda = jeda_awal * (2 ** (percobaan - 1)) + random.uniform(0, 0.1)
            await asyncio.sleep(jeda)
Hasil uji: fungsi yang gagal dua kali karena koneksi putus berhasil pada percobaan ketiga, dan fungsi yang selalu lambat memicu galat timeout setelah dua percobaan sesuai batas yang ditetapkan.
Percobaan ulang bisa berarti bayar ulang. Jika permintaan sudah sampai ke model tetapi balasannya hilang, mengulangnya bisa menagih token dua kali. Ulangi hanya untuk galat yang aman diulang, batasi jumlah percobaan, dan pertimbangkan kunci idempotensi. Jangan pernah membuat percobaan ulang tanpa batas.
Skill 5: Caching
Kunci cache harus memuat semua hal yang memengaruhi jawaban: model, instruksi sistem, dan masukan. Jika salah satu berubah, kuncinya berubah, sehingga Anda tidak menyajikan jawaban lama untuk konteks baru.
import hashlib, json, time

class CacheJawaban:
    def __init__(self, ttl_detik=3600):
        self.ttl = ttl_detik
        self.data = {}

    def kunci(self, model, instruksi, masukan):
        mentah = json.dumps([model, instruksi, masukan.strip()], ensure_ascii=False)
        return hashlib.sha256(mentah.encode()).hexdigest()

    def ambil(self, k):
        item = self.data.get(k)
        if item and time.time() - item[0] < self.ttl:
            return item[1]
        return None

    def simpan(self, k, nilai):
        self.data[k] = (time.time(), nilai)
Hasil uji: sebelum disimpan, pengambilan mengembalikan kosong. Setelah disimpan, pertanyaan yang sama mengembalikan jawaban tersimpan, sedangkan pertanyaan berbeda menghasilkan kunci berbeda dan tidak salah ambil. Versi produksi biasanya memakai penyimpanan bersama seperti Redis, bukan kamus di memori proses.
Baca Juga:
Cache tidak cocok untuk semua kasus. Jangan menyimpan jawaban yang mengandung data pribadi untuk dibagikan ke pengguna lain, dan hati-hati pada jawaban yang bergantung pada waktu atau data yang sering berubah. Tetapkan masa berlaku (TTL) yang sesuai.
Skill 10: Log Terstruktur
Catat setiap panggilan model sebagai satu baris JSON dengan pengenal permintaan, model, status, latensi, dan jumlah token. Baris seperti ini mudah dicari dan dihitung.
import json, time, uuid, logging

logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("ai")

async def panggil_terlacak(fungsi, model, **kolom):
    id_permintaan = uuid.uuid4().hex[:8]
    mulai = time.perf_counter()
    status = "ok"
    try:
        return await fungsi()
    except Exception as e:
        status = type(e).__name__
        raise
    finally:
        log.info(json.dumps({
            "id": id_permintaan, "model": model, "status": status,
            "latensi_ms": round((time.perf_counter() - mulai) * 1000), **kolom
        }))
Hasil uji: panggilan sukses menghasilkan satu baris log dengan status "ok" dan latensinya, sedangkan panggilan yang gagal tetap tercatat dengan status nama galatnya. Dari log seperti ini Anda bisa menghitung biaya per fitur dan menemukan kapan latensi mulai naik. Jangan mencatat isi percakapan mentah bila memuat data sensitif.
Skill Lain yang Sering Diremehkan
Antrean
Tugas panjang jangan ditahan di permintaan HTTP
Meringkas dokumen ratusan halaman bisa memakan menit. Terima permintaannya, simpan sebagai tugas, kembalikan pengenal tugas, lalu biarkan pekerja latar mengerjakannya. Pengguna memeriksa status atau menerima notifikasi.
Hak akses
Filter di database, bukan di prompt
Jangan mengandalkan instruksi "jangan tampilkan dokumen rahasia" kepada model. Batasi potongan yang boleh diambil sejak query pencarian, sehingga dokumen terlarang tidak pernah sampai ke model.
Validasi
Perlakukan keluaran model sebagai masukan tak tepercaya
Validasi bentuk dan isi sebelum menyimpan atau bertindak, seperti dibahas di structured output LLM. Model bisa salah, atau dimanipulasi oleh teks di dalam masukannya.
Konfigurasi
Jadikan model dan batas sebagai pengaturan
Nama model, batas token, dan TTL cache sebaiknya berada di konfigurasi, bukan tertanam di kode. Model sering diganti atau dipensiunkan, dan Anda ingin mengganti tanpa menulis ulang.
Urutan Belajar Berdasarkan Kebutuhan
Sebelum fitur AI pertamaDesain API, async, timeout dan retry, database dasar, penyimpanan rahasia, dan log sederhana.
Sebelum rilis ke penggunaCaching, rate limiting, hak akses, idempotency, dan pengujian dengan dataset evaluasi.
Saat skala membesarAntrean dan pekerja latar, tracing terdistribusi, kuota dan anggaran per tim, serta pemantauan biaya.
Urutan ini disusun dari akibat kegagalan: tingkat pertama mencegah fitur runtuh, tingkat kedua mencegah kerugian dan kebocoran, tingkat ketiga menjaga sistem tetap terkendali saat pemakaian tumbuh. Dasar pemanggilan model dari Python ada di panduan Gemini API dengan Python.
Daftar Periksa: Seberapa Siap Backend Anda untuk Fitur AI?
Jawab ya atau tidak untuk fitur AI yang sedang Anda buat:
- Apakah setiap panggilan model punya batas waktu? Tanpa itu, satu model yang macet bisa menahan seluruh server.
- Apakah percobaan ulang dibatasi dan hanya untuk galat yang aman diulang?
- Apakah permintaan ganda dari klien bisa dikenali?
- Apakah ada batas per pengguna dan peringatan biaya harian?
- Apakah Anda tahu biaya rata-rata per permintaan dari data log?
- Apakah kunci API tersimpan di luar kode dan luar repositori?
- Apakah hak akses diterapkan di query, bukan di prompt?
- Apakah keluaran model divalidasi sebelum dipakai?
- Apakah ada dataset uji yang dijalankan setiap kali prompt atau model berubah?
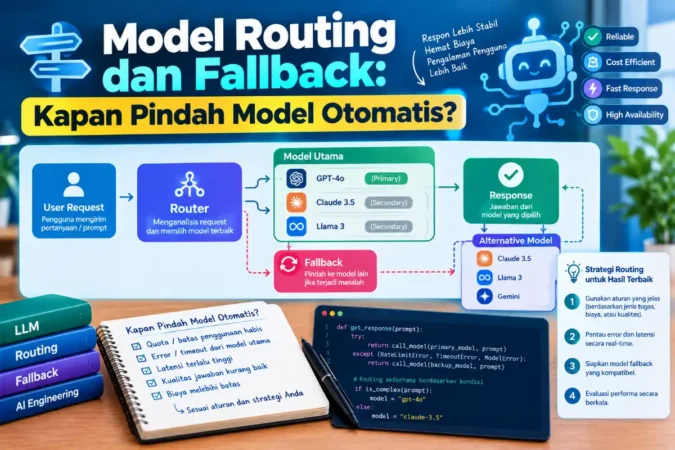
- Apakah ada jalur cadangan saat model gagal atau lambat?
Jika lebih dari tiga jawaban "tidak", perbaiki dulu fondasi sebelum menambah fitur. Untuk melihat skill ini dalam konteks jalur karier, lihat juga artikel skill programmer yang dibutuhkan di era AI.
Baca Juga:
Kesalahan Umum
- Menyelesaikan masalah backend dengan prompt. Jawaban lambat atau tagihan bengkak tidak bisa diperbaiki dengan kata-kata yang lebih manis.
- Memanggil model dari klien. Kunci API di aplikasi klien bisa dicuri. Panggil dari server Anda.
- Menganggap model sebagai fungsi deterministik. Keluarannya bisa berubah antarpanggilan dan antarversi model, jadi uji dan pantau.
- Mengabaikan biaya sampai tagihan datang. Catat token dan biaya sejak hari pertama.
- Mencatat terlalu banyak. Log yang menyimpan percakapan mentah bisa menjadi kebocoran data sendiri.
Pilih Satu Skill dan Praktikkan Minggu Ini
Ambil fitur AI kecil yang sudah Anda buat, lalu tambahkan batas waktu, percobaan ulang terbatas, dan log terstruktur. Dokumentasi resmi asyncio berikut membantu memahami pemanggilan non-blokir yang dipakai pada contoh.
Dokumentasi asyncio Python Ide Proyek untuk BerlatihFAQ
Skill backend apa yang paling penting untuk AI engineer?
Untuk pemula, mulai dari desain API, pemanggilan async, timeout dan percobaan ulang, database dasar, penyimpanan rahasia, dan logging. Keenamnya mencegah fitur AI runtuh di produksi. Skill lain menyusul sesuai skala dan risiko.
Apakah harus jago backend sebelum belajar AI?
Tidak wajib, tetapi sangat membantu. Fitur AI yang tidak punya fondasi backend biasanya berhenti sebagai demo. Anda bisa belajar keduanya berdampingan, dengan proyek kecil yang mengasah keduanya.
Kenapa fitur AI butuh retry dan timeout?
Model adalah layanan eksternal yang bisa lambat atau gagal sesekali. Timeout mencegah permintaan menggantung tanpa batas, dan percobaan ulang yang terbatas membantu pulih dari gangguan singkat tanpa menagih biaya berlebihan.
Apakah caching aman untuk jawaban AI?
Aman jika kunci cache memuat semua faktor yang memengaruhi jawaban dan masa berlakunya sesuai. Hindari menyimpan jawaban yang berisi data pribadi untuk dibagikan lintas pengguna, dan hati-hati pada topik yang cepat berubah.
Bagaimana mengendalikan biaya API model?
Catat token dan biaya per permintaan, pasang batas per pengguna dan peringatan harian, gunakan cache untuk pertanyaan berulang, dan batasi percobaan ulang. Perhitungan lengkapnya dibahas di artikel biaya token.
Apakah harus memakai antrean untuk semua fitur AI?
Tidak. Fitur yang jawabannya cepat cukup dilayani langsung. Antrean berguna untuk tugas panjang seperti meringkas dokumen besar atau memproses banyak berkas, agar permintaan HTTP tidak tertahan.
Bahasa atau framework apa yang sebaiknya dipelajari?
Prinsipnya sama di semua bahasa. Python populer karena ekosistem AI-nya, sementara Node.js juga umum. Pilih yang sudah Anda kuasai lalu dalami konsep async, penanganan galat, dan observability.
Kesimpulan
Membangun fitur AI yang bertahan di produksi lebih banyak soal rekayasa backend daripada soal prompt. Dua belas skill di atas menjawab masalah yang hampir pasti Anda temui: model yang lambat, biaya yang membengkak, data yang bocor, dan sistem yang tak terpantau.
Wawasan yang sering terlewat: kegagalan fitur AI biasanya bukan kegagalan kecerdasan, melainkan kegagalan yang kita anggap sepele, seperti tidak ada timeout, tidak ada batas biaya, dan tidak ada log. Mulailah dari tiga hal termurah yang paling berdampak: batas waktu, percobaan ulang terbatas, dan log terstruktur. Lalu tambahkan sisanya sesuai risiko dan skala. Dengan begitu Anda bukan hanya bisa membuat demo AI, tetapi bisa mempertanggungjawabkannya di produksi.
Baca Juga: