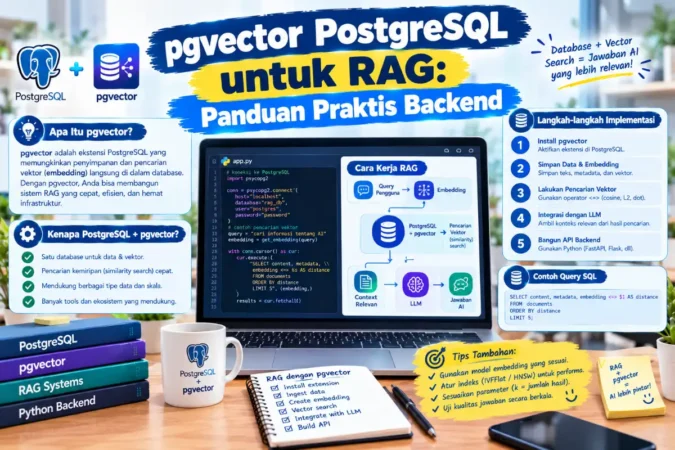
Begitu Anda mulai membangun sistem RAG, godaan berikutnya hampir selalu sama: “kita butuh vector database”. Padahal bagi banyak tim backend, jawabannya sudah ada di server yang berjalan: PostgreSQL. Dengan ekstensi pgvector, database yang sudah Anda kenal bisa menyimpan embedding dan mencari potongan dokumen yang paling mirip maknanya.
Artikel ini membahas kapan pgvector cukup, cara menyusun skema untuk RAG, memilih indeks, menulis query pencarian dari Python, dan jebakan nyata yang kami temui saat menguji semuanya di PostgreSQL 16 dengan pgvector 0.6.0. Beberapa jebakan itu tidak akan Anda temukan di tutorial singkat.
pgvector Adalah
pgvector adalah ekstensi open source untuk PostgreSQL yang menambahkan tipe data vektor, operator jarak, dan indeks pencarian tetangga terdekat. Dengan begitu embedding bisa disimpan dan dicari di database yang sama dengan data aplikasi Anda.
Kalau Anda belum akrab dengan konsepnya, dasar embedding dibahas di artikel embedding adalah, dan alur lengkap pemakaiannya ada di RAG adalah. Di sini kita fokus pada sisi database.
Bukan soal mana yang “lebih canggih”, melainkan mana yang sesuai kebutuhan dan kemampuan tim Anda.
pgvector biasanya cukup jikadata ribuan sampai jutaan potongan, tim sudah mahir PostgreSQL, Anda butuh menggabungkan pencarian makna dengan filter data bisnis, dan ingin satu sistem untuk dikelola.
Pertimbangkan alat khusus jikaskala vektor sangat besar, kebutuhan latensi ketat pada beban tinggi, atau tim memerlukan fitur pencarian vektor yang tidak tersedia di PostgreSQL.
Kelebihan utama pgvector bagi pengembang backend: satu database, satu cara backup, satu sistem hak akses, dan Anda bisa memakai SQL biasa untuk menggabungkan hasil pencarian dengan tabel lain. Kekurangannya, Anda ikut bertanggung jawab menyetel indeks dan memantau kinerja. Ambil keputusan dari data Anda sendiri: uji dulu dengan volume dan pola query yang mirip produksi.
Langkah 1: Aktifkan Ekstensi dan Rancang Skema
Skema RAG yang sederhana memisahkan dokumen dan potongannya. Tiap potongan menyimpan teks, embedding, dan kolom pendukung untuk penyaringan, misalnya unit atau hak akses.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE dokumen (
  id bigserial PRIMARY KEY,
  judul text NOT NULL,
  sumber text,
  diperbarui timestamptz DEFAULT now()
);

CREATE TABLE potongan (
  id bigserial PRIMARY KEY,
  dokumen_id bigint REFERENCES dokumen(id) ON DELETE CASCADE,
  urutan int NOT NULL,
  isi text NOT NULL,
  unit text,
  embedding vector(768)
);
Angka 768 adalah jumlah dimensi vektor dan harus sama persis dengan keluaran model embedding yang Anda pakai. Salah satu saja, dan penyimpanan akan ditolak. Kolom unit adalah contoh metadata untuk membatasi hasil pencarian, misalnya hanya dokumen milik tim HR.
Jebakan Dimensi: Batas 2.000 untuk Indeks
Ini jebakan yang paling sering menjebak pemula. Tipe vector bisa menyimpan hingga 16.000 dimensi, tetapi indeks HNSW dan IVFFlat hanya mendukung sampai 2.000 dimensi. Kami mencobanya: membuat indeks HNSW pada kolom vector(3072) menghasilkan galat “column cannot have more than 2000 dimensions for hnsw index”.
Ini penting karena beberapa model embedding, termasuk Gemini seperti dibahas di artikel embedding kami, menghasilkan 3.072 dimensi secara bawaan. Ada tiga jalan keluar:
Kecilkan dimensi keluaran jika model mendukung, misalnya ke 768 atau 1.536, dan buat kolom sesuai angka itu. Pada uji kami, indeks HNSW untuk vector(1536) berhasil dibuat.
Pakai tipe presisi setengah (halfvec) yang mampu diindeks pada dimensi lebih besar. Fitur ini ada di pgvector versi yang lebih baru. Di versi 0.6.0 yang kami pakai, tipe halfvec belum ada, jadi cek versi ekstensi di server Anda dan dokumentasi resminya.
Lewati indeks untuk data kecil dan biarkan pencarian eksak. Ini pilihan sah sampai jumlah data membuat query melambat.
Mengecilkan dimensi memang bisa sedikit mengurangi ketelitian pencarian, jadi ukur dampaknya dengan dataset uji seperti dibahas di evaluasi LLM.
Operator Jarak dan Cosine Similarity
Operator
Arti
Catatan
<=>
Jarak kosinus
Pilihan paling umum untuk teks. Makin kecil, makin mirip.
<->
Jarak Euclidean (L2)
Dipakai bila model menganjurkannya.
<#>
Inner product negatif
Nilainya negatif, urutkan menaik.
Untuk menampilkan skor kemiripan yang lebih mudah dibaca, hitung 1 - (embedding <=> vektor_pertanyaan). Nilai mendekati 1 berarti sangat mirip. Pastikan operator pada indeks (misalnya vector_cosine_ops) sama dengan operator yang Anda pakai di query.
Langkah 2: Buat Indeks
-- HNSW: umumnya lebih akurat dan cepat saat query, memakan waktu build dan memori lebih besar
CREATE INDEX ON potongan USING hnsw (embedding vector_cosine_ops);

-- Alternatif IVFFlat: build lebih cepat, perlu data terlebih dahulu
-- CREATE INDEX ON potongan USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);
Kedua indeks bersifat pendekatan (approximate): hasilnya sangat cepat, tetapi tidak dijamin selalu sama dengan pencarian eksak. Anda bisa mengatur kompromi antara kecepatan dan ketelitian saat query, misalnya dengan SET hnsw.ef_search = 100; untuk HNSW. Nilai lebih besar biasanya lebih teliti dan lebih lambat.
Langkah 3: Cari dari Python
Berikut fungsi pencarian dengan psycopg. Vektor pertanyaan dikirim sebagai parameter dan di-cast ke tipe vector. Fungsi ini kami jalankan di database uji dan mengembalikan empat potongan terurut dari yang paling mirip.
import psycopg

def cari(conn, vektor_pertanyaan, unit, k=4):
    sql = """
        SELECT p.id, d.judul, p.isi,
               1 - (p.embedding <=> %s::vector) AS kemiripan
        FROM potongan p
        JOIN dokumen d ON d.id = p.dokumen_id
        WHERE p.unit = %s
        ORDER BY p.embedding <=> %s::vector
        LIMIT %s
    """
    v = str(list(vektor_pertanyaan))
    with conn.cursor() as cur:
        cur.execute(sql, (v, unit, v, k))
        return cur.fetchall()
Vektor pertanyaan berasal dari model embedding yang sama dengan yang dipakai saat mengisi tabel. Hasilnya kemudian disisipkan ke prompt sebagai konteks, sesuai alur RAG yang dijelaskan di atas.
Temuan Uji: Tiga Jebakan Nyata
Lingkungan uji: PostgreSQL 16 dengan pgvector 0.6.0, tabel berisi 2.000 potongan berdimensi 768 dan indeks HNSW. Dua temuan pertama dikonfirmasi lewat rencana query (EXPLAIN). Semua data uji berupa vektor acak, jadi angka kemiripannya tidak bermakna. Yang kami periksa hanyalah perilaku query dan indeks.
1
Vektor pertanyaan harus berupa parameter atau subquery
Ketika kami mengambil vektor pertanyaan dari tabel lain lewat join, PostgreSQL memilih pemindaian penuh (Seq Scan) dan indeks tidak terpakai. Ketika vektor dikirim sebagai parameter seperti pada fungsi di atas, rencana query menampilkan pemindaian indeks HNSW. Jadi kalau pencarian Anda lambat padahal indeks sudah ada, periksa dulu bentuk query dengan EXPLAIN.
2
Filter diterapkan setelah indeks dipindai
Pada rencana query kami, kondisi unit = 'hr' muncul sebagai Filter di bawah pemindaian indeks. Artinya indeks lebih dulu mengambil kandidat terdekat, lalu baris yang tidak cocok dibuang. Akibatnya, dengan filter yang ketat, Anda bisa mendapat kurang dari k hasil. Opsinya: naikkan hnsw.ef_search, gunakan fitur pemindaian iteratif di pgvector versi baru, atau pisahkan data (misalnya partisi atau indeks per unit) bila penyaringan menjadi kebutuhan utama.
3
Mengganti model embedding berarti membuat ulang semua vektor
Vektor dari dua model berbeda tidak bisa dibandingkan, bahkan jika dimensinya sama. Simpan nama dan versi model di kolom atau tabel terpisah, agar Anda tahu vektor mana yang perlu dibuat ulang saat berganti.
Hal Operasional yang Sering Terlupa
Akses
Batasi hasil sesuai hak akses pengguna
Sistem RAG internal sering menyimpan dokumen dengan tingkat kerahasiaan berbeda. Sertakan filter hak akses di setiap query pencarian, dan jangan mengandalkan model untuk “menyembunyikan” isinya. Fitur keamanan tingkat baris (row-level security) di PostgreSQL bisa menjadi lapisan tambahan.
Backup dan pemulihan ikut kebijakan PostgreSQL Anda. Ini salah satu keuntungan terbesar dibanding sistem terpisah.
Memori dan ukuran indeks. Indeks HNSW cukup rakus memori. Pantau ukuran tabel dan indeks saat data bertambah.
Pembaruan dokumen. Saat dokumen berubah, hapus potongan lama dan buat ulang, dan jangan biarkan versi usang tetap dicari.
Ukur kualitas pencarian. Bandingkan hasil indeks pendekatan dengan pencarian eksak pada sampel pertanyaan untuk melihat seberapa banyak yang terlewat.
Catatan kritis: uji kami memakai data acak berskala kecil, sehingga tidak membuktikan kecepatan atau ketelitian pada data nyata Anda. Kinerja pgvector bergantung pada jumlah data, dimensi, pengaturan indeks, dan perangkat keras. Ulangi uji dengan data dan beban yang menyerupai produksi sebelum mengambil keputusan.
Urutan Kerja yang Disarankan
Tentukan model embedding dan dimensinya, lalu pastikan dimensinya bisa diindeks (2.000 atau kurang untuk tipe vector).
Buat skema dokumen dan potongan dengan metadata untuk penyaringan dan hak akses.
Isi data dan buat indeks setelah data awal masuk.
Tulis query pencarian dengan vektor sebagai parameter, lalu periksa dengan EXPLAIN bahwa indeks terpakai.
Uji dengan pertanyaan nyata dan ukur apakah potongan yang benar muncul di hasil teratas.
Pantau dan tetapkan rencana untuk pembaruan dokumen dan penggantian model.
Pasang pgvector di PostgreSQL lokal, buat tabel potongan, lalu isi dengan beberapa puluh potongan dokumen yang Anda kenal isinya. Dokumentasi resmi pgvector berisi daftar operator, opsi indeks, dan catatan versi terbaru.
pgvector adalah ekstensi PostgreSQL yang menambahkan tipe data vektor, operator jarak, dan indeks pencarian tetangga terdekat, sehingga embedding bisa disimpan dan dicari di database yang sama dengan data aplikasi.
Apakah pgvector cukup untuk RAG?
Untuk banyak aplikasi berskala kecil sampai menengah, ya. Keunggulannya adalah satu sistem untuk data dan vektor. Untuk skala sangat besar atau kebutuhan khusus, uji dulu apakah kinerjanya memenuhi target Anda.
Kenapa indeks HNSW gagal dibuat pada vektor 3.072 dimensi?
Karena indeks HNSW dan IVFFlat pada tipe vector dibatasi sampai 2.000 dimensi. Kecilkan dimensi keluaran model, pakai tipe presisi setengah bila versi pgvector Anda mendukung, atau lewati indeks untuk data kecil.
Apa bedanya HNSW dan IVFFlat?
HNSW umumnya lebih akurat dan cepat saat query tetapi lebih berat saat dibangun dan memakai lebih banyak memori. IVFFlat lebih cepat dibangun tetapi butuh data terlebih dahulu dan sensitif terhadap pengaturannya. Coba keduanya pada data Anda.
Kenapa hasil pencarian saya kurang dari jumlah yang diminta?
Kemungkinan karena filter WHERE diterapkan setelah indeks dipindai, sehingga sebagian kandidat terbuang. Naikkan parameter pencarian, gunakan pemindaian iteratif pada versi baru, atau pisahkan data per kategori.
Bisakah saya mengganti model embedding tanpa mengulang semuanya?
Tidak. Vektor dari model berbeda tidak sebanding, jadi semua potongan harus dibuat ulang vektornya saat berganti model.
Apakah pgvector aman untuk data rahasia?
Keamanannya mengikuti pengaturan PostgreSQL Anda. Tetap terapkan filter hak akses di setiap query, batasi akses database, dan perhatikan bahwa potongan yang diambil akan dikirim ke model saat menjawab.
pgvector membuat RAG bisa dibangun di atas PostgreSQL yang sudah Anda kelola: satu database untuk data dan vektor, dengan SQL yang sudah dikenal. Untuk banyak proyek, ini cara paling ringkas untuk mulai tanpa menambah komponen baru.
Wawasan yang sering terlewat: kesulitan sebenarnya bukan di sintaks, melainkan di detail yang tidak tampak di tutorial singkat. Batas 2.000 dimensi untuk indeks, vektor pertanyaan yang harus berupa parameter, filter yang berjalan setelah indeks, dan biaya membuat ulang vektor saat berganti model. Periksa rencana query dengan EXPLAIN, uji dengan pertanyaan nyata, dan catat versi ekstensi Anda. Dengan begitu pilihan pgvector Anda bertumpu pada bukti, bukan asumsi.