Daftar Isi:
Skema Database Riwayat Percakapan AI: Pola dan Query
Fitur chat berbasis LLM butuh lebih dari sekadar tabel “pesan” biasa — riwayat percakapan harus bisa diambil sebagai konteks untuk model, dibatasi berdasarkan token bukan jumlah baris, dan tetap konsisten urutannya. Ini skema dan query yang diuji langsung di PostgreSQL, termasuk satu kesalahan query yang mudah lolos review tapi mengirim konteks yang salah ke model.
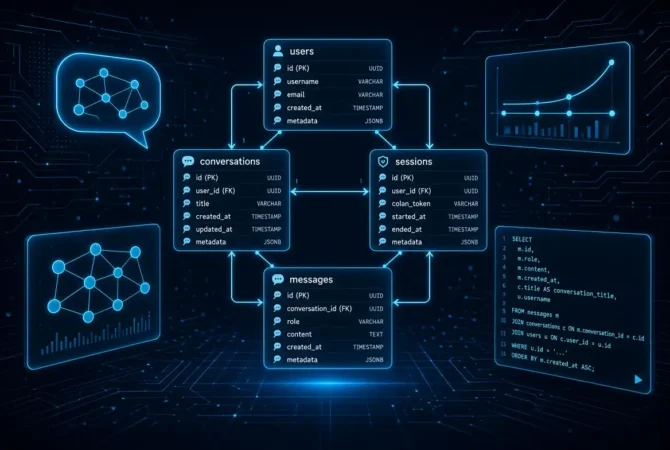
Menyimpan riwayat chat terlihat sederhana — satu tabel dengan kolom pengirim dan isi pesan. Tapi begitu riwayat itu perlu dipakai ulang sebagai konteks untuk panggilan model berikutnya, beberapa keputusan desain jadi penting: bagaimana mengambil N pesan terakhir dengan urutan yang benar, bagaimana membatasi konteks berdasarkan anggaran token (bukan sekadar jumlah pesan), dan bagaimana memastikan menghapus percakapan tidak meninggalkan pesan yatim di database.
Skema Dasar: Dua Tabel, Bukan Satu
CREATE TABLE percakapan (
    id bigserial PRIMARY KEY,
    pengguna_id text NOT NULL,
    judul text,
    dibuat_pada timestamptz NOT NULL DEFAULT now(),
    diperbarui_pada timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE pesan (
    id bigserial PRIMARY KEY,
    percakapan_id bigint NOT NULL REFERENCES percakapan(id) ON DELETE CASCADE,
    peran text NOT NULL CHECK (peran IN ('sistem', 'pengguna', 'asisten')),
    isi text NOT NULL,
    token_perkiraan int NOT NULL DEFAULT 0,
    urutan int NOT NULL,
    dibuat_pada timestamptz NOT NULL DEFAULT now(),
    UNIQUE (percakapan_id, urutan)
);

CREATE INDEX ON pesan (percakapan_id, urutan DESC);
Kenapa kolom urutan terpisah dari id?
id global bisa dipakai untuk urutan lintas semua percakapan, tapi urutan per-percakapan (dimulai dari 1 di setiap percakapan baru) membuat query “N pesan terakhir dalam percakapan ini” lebih jelas dan tidak bergantung pada nilai id yang terus bertambah global.
Kenapa token_perkiraan disimpan, bukan dihitung ulang?
Menghitung ulang token setiap kali mengambil riwayat berarti kerja tokenizer berulang untuk pesan yang isinya tidak pernah berubah. Menyimpannya sekali saat pesan dibuat jauh lebih murah — angka ini juga yang jadi dasar perhitungan biaya token per percakapan.
Kenapa ON DELETE CASCADE?
Tanpa ini, menghapus baris di percakapan meninggalkan pesan yatim yang masih menunjuk ke percakapan_id yang sudah tidak ada — diuji dan dikonfirmasi di bawah bahwa cascade menghapus semua pesan terkait secara otomatis.
Jebakan yang Terbukti Nyata: Urutan LIMIT yang Salah
Mengambil “N pesan terakhir” untuk dijadikan konteks terdengar sederhana, tapi urutan operasi ORDER BY dan LIMIT yang salah memberi hasil yang salah tanpa error apa pun — query tetap berjalan, hanya datanya yang keliru.
Diuji dan terbukti salah: query
SELECT ... FROM pesan WHERE percakapan_id = 1 ORDER BY urutan ASC LIMIT 4 — kelihatannya wajar untuk “ambil 4 pesan” — ternyata mengembalikan 4 pesan tertua dalam percakapan (urutan 1-4), bukan 4 pesan terbaru. Untuk percakapan yang sudah panjang, ini berarti model menerima konteks dari awal obrolan yang sudah tidak relevan, sementara pesan-pesan terbaru yang justru paling penting tidak pernah terkirim.
Query yang benar dan teruji: urutkan
DESC dan LIMIT dulu di subquery untuk mengambil yang terbaru, baru urutkan ulang ASC di lapisan luar supaya urutan kronologis tetap benar saat dikirim ke model:
SELECT peran, isi, urutan FROM (
    SELECT peran, isi, urutan
    FROM pesan
    WHERE percakapan_id = 1
    ORDER BY urutan DESC
    LIMIT 4
) sub
ORDER BY urutan ASC;
Diuji dengan 7 pesan dalam satu percakapan — query ini benar mengembalikan pesan urutan 4-7 (4 pesan terbaru) dalam urutan kronologis yang tepat untuk dikirim sebagai riwayat ke model, persis kebalikan dari hasil query naif di atas.
Truncation Berbasis Anggaran Token, Bukan Jumlah Pesan
Membatasi konteks berdasarkan jumlah pesan tetap (misal “4 pesan terakhir”) tidak memperhitungkan bahwa panjang tiap pesan berbeda-beda — 4 pesan pendek jauh lebih murah dari 4 pesan panjang. Pola yang lebih akurat: akumulasi token dari yang terbaru sampai mendekati anggaran yang ditentukan.
WITH terbaru AS (
    SELECT peran, isi, token_perkiraan, urutan,
           SUM(token_perkiraan) OVER (ORDER BY urutan DESC) AS kumulatif
    FROM pesan
    WHERE percakapan_id = 1
)
SELECT peran, isi, urutan, kumulatif FROM terbaru
WHERE kumulatif <= 150
ORDER BY urutan ASC;
Diuji dengan 7 pesan bercampur token pendek dan panjang (5-90 token per pesan) dan anggaran 150 token — window function SUM() OVER (ORDER BY urutan DESC) menghitung token kumulatif dari pesan terbaru mundur, dan query benar berhenti menyertakan pesan begitu kumulatifnya akan melampaui anggaran. Hasilnya: hanya 2 pesan terakhir yang masuk (kumulatif 90 dan 98 token), sementara pesan urutan 5 yang token-nya 75 dikeluarkan karena akan mendorong total ke 173 — melebihi anggaran 150. Ini jauh lebih tepat dibanding menghitung berdasarkan jumlah pesan tetap, yang akan menyertakan pesan urutan 5 itu tanpa mempedulikan bahwa panjangnya jauh lebih besar dari pesan-pesan pendek lainnya.
Cascading Delete: Diuji dan Dikonfirmasi
Diuji langsung: percakapan dengan 7 pesan dihapus lewat
DELETE FROM percakapan WHERE id = 1 — pengecekan setelahnya mengonfirmasi jumlah pesan yang tersisa untuk percakapan_id tersebut adalah 0. ON DELETE CASCADE pada foreign key bekerja sesuai desain, tanpa perlu kode aplikasi terpisah untuk membersihkan pesan yatim.
Perbandingan Pendekatan Pembatasan Konteks
| Pendekatan | Kelebihan | Kelemahan |
|---|---|---|
| N pesan terakhir (tetap) | Sederhana, mudah diprediksi | Tidak memperhitungkan panjang pesan yang bervariasi |
| Anggaran token kumulatif | Akurat mencerminkan batas konteks model sesungguhnya | Butuh token_perkiraan tersimpan dan query sedikit lebih kompleks |
| Ringkasan otomatis pesan lama | Bisa mempertahankan konteks panjang tanpa membengkak | Butuh panggilan model tambahan untuk meringkas, biaya ekstra |
Pertanyaan yang Sering Muncul
Apakah perlu menyimpan pesan sistem (system prompt) di tabel yang sama?
Bisa, seperti contoh skema di atas dengan peran = 'sistem' — tapi kalau system prompt sama untuk semua percakapan (bukan spesifik per-percakapan), menyimpannya terpisah di kode aplikasi atau tabel konfigurasi biasanya lebih rapi daripada mengulang baris yang sama di setiap percakapan.
Baca Juga:
Bagaimana kalau butuh mendukung edit atau hapus pesan?
Untuk hapus, pertimbangkan soft-delete (kolom dihapus_pada) daripada hapus fisik, supaya urutan tetap konsisten dan riwayat audit tidak hilang. Untuk edit, menyimpan versi baru sebagai baris terpisah (dengan penanda revisi) lebih aman daripada menimpa isi pesan lama, terutama kalau pesan itu sudah pernah dikirim sebagai konteks ke model.
Apakah window function seperti di atas berat untuk percakapan yang sangat panjang?
Untuk percakapan dengan ribuan pesan, index pada (percakapan_id, urutan DESC) seperti di skema di atas membantu, tapi pola yang lebih efisien untuk kasus ekstrem adalah menyimpan ringkasan berkala (misalnya tiap 50 pesan) dan hanya melakukan query token kumulatif pada pesan-pesan setelah ringkasan terakhir.
Perlu embedding vektor di tabel pesan untuk pencarian semantik riwayat lama?
Kalau aplikasi butuh mencari kembali topik lama dalam percakapan panjang (bukan hanya konteks berurutan terbaru), kolom vector tambahan dengan pgvector bisa ditambahkan untuk pencarian berbasis kemiripan makna, bukan hanya urutan waktu.
Kesimpulan
Skema dua tabel (percakapan dan pesan) cukup untuk kebanyakan fitur chat berbasis LLM, tapi query di sekitarnya yang menentukan apakah konteks yang dikirim ke model benar atau diam-diam salah. Pengujian di atas membuktikan satu kesalahan yang mudah lolos review kode: urutan ORDER BY dan LIMIT yang salah mengambil pesan tertua alih-alih terbaru, tanpa error yang memberi tahu. Anggaran token berbasis window function memberi kontrol yang lebih akurat dibanding sekadar membatasi jumlah pesan, dan ON DELETE CASCADE menghilangkan satu kelas bug (pesan yatim) tanpa kode tambahan.
Artikel terkait: biaya token LLM API.
Mau lanjut ke penyimpanan embedding untuk pencarian semantik?
Baca cara setup pgvector di PostgreSQL untuk kebutuhan RAG, lengkap dengan temuan indeks HNSW.
Baca Selengkapnya